
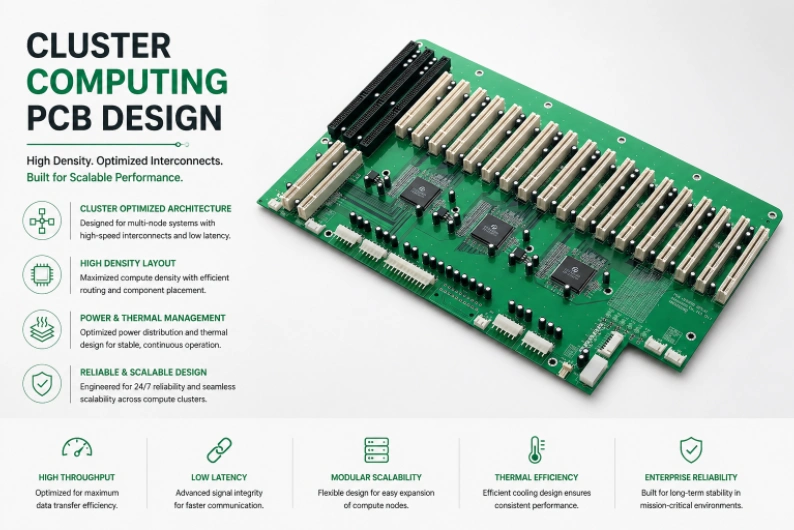
Der globale HPC-Cluster-Markt überstieg 2024 die Marke von 49 Milliarden US-Dollar. Dabei treiben KI-Training in Unternehmen und wissenschaftliche Simulationen die Nachfrage nach einer engeren Knotenintegration, schnelleren Interconnect-Bandbreiten und GPU-dichten Konfigurationen voran, die das Blade-PCB-Design an seine Grenzen bringen. Cluster Computing verbindet gemeinsam platzierte Knoten über hochbandbreitige Interconnects mit geringer Latenz — und ermöglicht so eng gekoppelte parallele Workloads, bei denen Knoten während MPI-Barrieren-Synchronisationen, All-Reduce-Operationen und Nachbaraustausch in Stencil-Berechnungen jede Millisekunde Daten austauschen.
Die entscheidende Unterscheidung zwischen Cluster Computing und lose gekoppelten verteilten Systemen ist die Kommunikationsintensität. Eine CFD-Simulation, die über 512 Cluster-Knoten ausgeführt wird, führt tausende Male pro Sekunde MPI_Allreduce-Operationen durch, die jeden Knoten einbeziehen — wobei jede Synchronisation darauf wartet, dass der langsamste Knoten abgeschlossen ist. Ein KI-Trainingsjob, der eine datenparallele Gradienten-Mittelwertbildung über 256 GPU-Knoten durchführt, führt nach jedem Mini-Batch All-Reduce-Operationen aus, wobei die Netzwerklatenz direkt zur Trainingsiterationszeit beiträgt. Diese Kommunikationsintensität bedeutet, dass der Interconnect-Pfad — und die PCB, die ihn trägt — bestimmt, ob das Hinzufügen von Knoten die Leistung verbessert oder Overhead erzeugt.
HILPCB fertigt Cluster-Computing-PCBs einschließlich 500-mm-Boards im Blade-Format mit 0,2 % Ebenheitstoleranz, InfiniBand HDR/NDR-Adapterkarten und Midplane-/Backplane-Baugruppen — für Systemintegratoren, die HPC- und KI-Trainingscluster in Nordamerika, Europa und dem asiatisch-pazifischen Raum aufbauen.
Menü-Navigation
- Interconnect-First Knotenarchitektur
- InfiniBand HDR/NDR und High-Speed Ethernet Routing
- Blade-Formfaktor: Routing in einem 30×500 mm Korridor
- Multi-Kilowatt Stromverteilung für GPU-dichte Blades
- Zuverlässigkeit für Non-Stop Cluster-Betrieb
- Integrierte Blade- und Midplane-Fertigung
Interconnect-First Knotenarchitektur
Moderne Cluster-Knoten basieren auf CPUs der Serverklasse oder GPU-Beschleunigern, unterstützt durch 8-12 DDR5-Kanäle, PCIe Gen 5-Erweiterungen und 200G/400G InfiniBand oder Ethernet-Interconnects. Die kritische Designphilosophie, die Cluster-Boards von allgemeinen Server-Boards unterscheidet, ist die Priorität des Interconnects — die Netzwerkschnittstelle erhält den kürzesten PCIe-Pfad, die besten Routing-Ebenen für die Signalintegrität und die günstigste thermische Position vor allen anderen Subsystemen.In einem Standardserver ist die Netzwerkschnittstelle eines von vielen Peripheriegeräten, das um PCIe-Lanes und Board-Routing-Ressourcen konkurriert. In einem Cluster-Knoten, der für MPI-Kommunikation konzipiert ist, arbeitet die Netzwerkschnittstelle kontinuierlich mit Wire-Rate — 400G InfiniBand NDR hält eine bidirektionale Bandbreite von 50 GB/s aufrecht, ohne die Leerlaufzeiten, die Cloud-Server zwischen unabhängigen Anforderungen erfahren. Dieses nachhaltige Auslastungsprofil bedeutet, dass jeder Signalintegritätsmangel auf dem Netzwerkpfad direkt den gesamten Rechendurchsatz des Clusters begrenzt.
Cluster-spezifische Design-Prioritäten
- Interconnect-First PCIe-Zuweisung: Netzwerk-HCA (Host Channel Adapter) oder SmartNIC, platziert auf PCIe Gen 5 x16-Lanes, die direkt vom CPU-Root-Komplex geroutet werden — dem kürzesten PCIe-Pfad auf dem Board mit dem geringsten Verlust und der geringsten Latenz. Speicher- und Peripheriegeräte erhalten verbleibende PCIe-Lanes über Switches oder Downstream-Ports.
- Multi-Channel DDR5 für datenintensives MPI: 8-12 DDR5-Kanäle, geroutet mit ±1 mil Byte-Lane-Anpassung auf High-Speed PCB-Lagen — zur Unterstützung der maximalen Speicherbandbreite für MPI-Pufferoperationen, bei denen die Leistung beim Packen/Entpacken von Nachrichten durch die Speicherbandbreite begrenzt ist.
- GPU-Beschleuniger-Integration: PCIe Gen 5 x16-Steckplätze für 4-8 GPU-Beschleuniger mit Stromversorgung, die 500W+ pro Karte durch Starkkupfer-Verteilung aus der 48V-Backplane-Leistung unterstützt — mit GPUs ausgestattete Cluster-Knoten leiten insgesamt 2.000-4.000W ab und erfordern eine Stromversorgungsinfrastruktur, die über das Standard-Server-Design hinausgeht.
- Midplane Connector-Schnittstelle: Connector-Footprints am Platinenrand, die exakt den Gehäuse-Midplane-Spezifikationen entsprechen, wobei die Impedanzkontinuität durch den Übergang von Platine zu Connector erhalten bleibt — verifiziert durch S-Parameter-Messung der Steckerschnittstelle während der Erstmuster-Qualifizierung.
InfiniBand HDR/NDR und High-Speed Ethernet Routing
Die MPI-Kommunikationslatenz bestimmt direkt die Skalierungseffizienz von Cluster-Anwendungen. Der PCB-Netzwerkpfad — vom CPU PCIe Root-Komplex über Board-Traces, Via-Übergänge und Connectoren bis hin zum Netzwerk-HCA-SerDes — trägt direkt zur Latenz jeder MPI-Operation bei und bestimmt die maximal erreichbare Fabric-Bandbreite.InfiniBand NDR mit 400G pro Port nutzt 4 Lanes mit 100G PAM4-Signalisierung — jede Lane arbeitet mit der gleichen Datenrate, die noch vor 3 Jahren für die anspruchsvollsten Switch-Boards ultra-verlustarme Materialien und eine präzise Fertigung erforderte. Jetzt gilt diese Anforderung an die Signalintegrität für jedes Cluster-Knoten-Board im System.
Interconnect Signalintegrität
- InfiniBand NDR 400G Routing: 4 Lanes × 100G PAM4 pro Port mit einer Einfügedämpfung von unter 4,5 dB bei 26,5 GHz Nyquist — erreicht durch verlustarme Laminate (Df < 0,003 bei 15 GHz), HVLP-Kupferfolie (Rz < 2,0 μm) und die Eliminierung von Via-Stubs durch Back-Drilling oder Blind-Via-Konstruktion bei allen Lagenübergängen.
- GPU-Direct RDMA Pfad-Optimierung: Direktes PCIe-Routing vom GPU-Slot zum NIC mit minimaler Hop-Anzahl (null PCIe-Switch-Traversierungen) und konstanter Impedanz durch alle Übergänge — ermöglicht GPU-zu-GPU-Kommunikation über Knoten hinweg bei 400G Wire-Rate ohne CPU-Beteiligung, was für kollektive NCCL/RCCL-Operationen im verteilten KI-Training kritisch ist.
- Deterministische Latenz durch den Hardware-Pfad: Impedanzdiskontinuitäten und Via-Stub-Resonanzen erzeugen Intersymbol-Interferenzen, die sich als datenabhängige Latenzvariation manifestieren — und die 99-Perzentil-Tail-Latenz erhöhen, die zum Engpass für MPI-Barrieren-Synchronisationen wird, bei denen die langsamste Kommunikation die systemweite Wartezeit bestimmt.
- Produktions-Augendiagramm-Verifizierung: Kanalqualität wird durch Augendiagramm-Messungen bei 100G PAM4-Datenraten an Erstmuster-Boards verifiziert — nicht nur durch statische TDR-Impedanzmessungen, die frequenzabhängige Verlustmechanismen übersehen, welche bei PAM4-Datenraten dominieren.
Blade-Formfaktor: Routing in einem 30×500 mm Korridor
Blade-Server maximieren die Rechendichte — ein 10U-Gehäuse fasst 16-20 Blades, die jeweils einen vollständigen Rechenknoten auf einer PCB enthalten, die auf eine Breite von etwa 30 mm und eine Länge von bis zu 500 mm beschränkt ist. Dieses extreme Seitenverhältnis (16:1 oder höher) schafft Routing- und thermische Herausforderungen, die sich grundlegend vom Standard-Server-Mainboard-Design unterscheiden.Blade-spezifische PCB-Design-Herausforderungen
- Längendominiertes Signal-Routing: Alle Hochgeschwindigkeitssignale durchqueren die volle Board-Länge von 400-500 mm — DDR5-Befehls-/Adressbusse erstrecken sich über 100-150 mm, PCIe x16-Lanes laufen 200+ mm bis zum Backplane-Connector und das Routing der Stromschienen erstreckt sich über das gesamte Board. Diese Längen zehren das Einfügedämpfungsbudget aggressiv auf — Standard-FR-4 mit Df 0,020 bei 10 GHz erzeugt 6+ dB Verlust auf DDR5-Routen, was das Timing-Margin überschreitet und die Wahl verlustarmer Materialien selbst für Schnittstellen erzwingt, die auf breiteren Board-Formaten mit Standard-FR-4 funktionieren.
- Mechanische Integration des Backplane-Connectors: Blade-seitige Connector-Footprints, die durch Gehäusespezifikationen (typischerweise PICMG 3.0 oder proprietär) festgelegt sind — das PCB-Layout muss exakte Pin-Positionen innerhalb von ±2 mil treffen, während die Impedanz des Differenzpaares durch die Übergangszone von Board zu Connector auf Multilayer-Konstruktionen mit 16-24 Lagen aufrechterhalten wird.
- Eingeschränkte thermische Extraktion: Der Blade-Abstand von 30 mm begrenzt die Kühlkörperhöhe auf 15-20 mm mit minimalem Querstrom-Luftstrom. Die Wärmeabfuhr stützt sich auf thermische Schnittstellen am Platinenrand (Kupfer-Wärmebrücken, die zu den Kühlprofilen des Gehäuses leiten) und Kontaktpads auf der Unterseite — innere Starkkupfer-Ebenen (2-3 oz) sorgen für die entscheidende laterale Wärmeverteilung von konzentrierten Chip-Footprints zu randmontierten Wärmebrücken.
- Verzugskontrolle bei extremen Seitenverhältnissen: Lange, dünne Blade-Boards sind von Natur aus anfällig für Verzug — das Länge-zu-Breite-Verhältnis verstärkt jede Asymmetrie der Kupferverteilung. Eine symmetrische Kupferverteilung über alle Lagen und eine ausgewogene Laminationssequenz halten die Ebenheit innerhalb von ±0,2 % der Diagonale — kritisch für ein zuverlässiges Stecken des Backplane-Connectors und einen konsistenten Kontakt der thermischen Schnittstelle.
Multi-Kilowatt Stromverteilung für GPU-dichte Blades
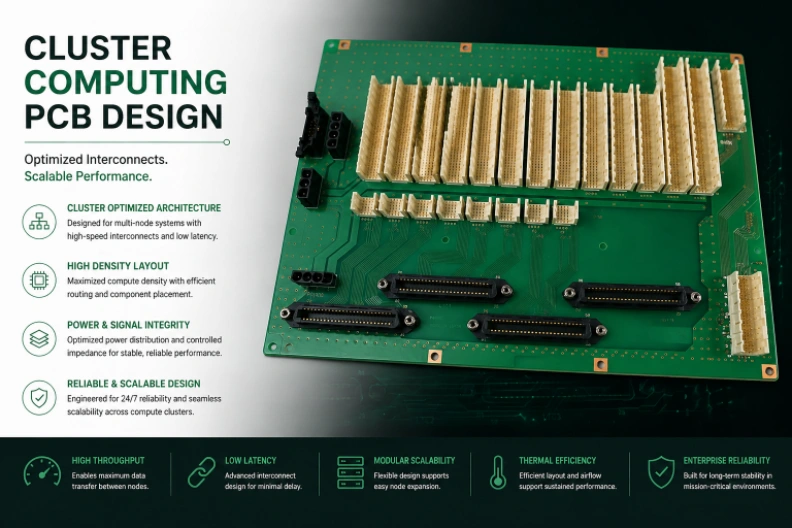
Mit GPUs ausgestattete Cluster-Blades stellen die höchste Leistungsdichte in jedem Computing-Formfaktor dar — ein Blade mit 2 CPUs und 4 GPU-Beschleunigern zieht 2.500-4.000W aus der 48V-Backplane-Stromversorgung, die vollständig in mehrere Sub-1V-Spannungsschienen innerhalb des Blade-PCB-Footprints umgewandelt wird. Ein 10U-Gehäuse mit 16 solcher Blades konzentriert 40-64 kW in weniger als einem halben Rack — eine Leistungsdichte, die die der meisten kommerziellen Elektronikgeräte um eine Größenordnung übersteigt.Blade-Stromarchitektur
- 48V Direct-to-Load Umwandlung: Zweistufige Architektur (48V→6V Intermediate Bus + 6V→Vcore Multiphase Buck), die Verteilungsverluste im Vergleich zum 12V-Bus um das 4- bis 6-fache reduziert. 48V-Routing auf dedizierten Power-Layern mit angemessener Kriechstrecke (>0,5 mm für funktionale Isolierung nach IEC 62368-1) und Schalttransientenmanagement für 48V-Halbbrückenwandler, die bei 300-500 kHz schalten.
- Aktives Current Sharing zwischen redundanten Eingängen: Redundante 48V-Einspeisungen aus der Midplane mit aktivem Stromausgleich — Aufrechterhaltung nahtloser Stromkontinuität bei N+1 Strommodulausfällen ohne Spannungstransienten, die Prozessoren zurücksetzen oder Berechnungen verfälschen würden.
- Voltage Droop Kompensation unter GPU-Transienten: Der Start von GPU-Kerneln erzeugt 200-300 A/μs Stromtransienten vom Leerlauf bis zur Volllast — die Load-Line-Impedanz ist kalibriert, um PCB-IR-Drop zu kompensieren und die Spannungsregelung am Prozessor-Die-Pad während des Transientenereignisses innerhalb von ±5 mV zu halten.
- Per-Rail Power Telemetrie: Shunt-basierte Strommessung (±1 % Genauigkeit) und Spannungsüberwachung auf jeder Hauptschiene — liefert Daten an das BMC für Power-Management auf Rack-Ebene, die Durchsetzung thermischer Richtlinien und vorausschauende Wartung durch Anomalieerkennung bei Stromverbrauchsmustern.
Zuverlässigkeit für Non-Stop Cluster-Betrieb
Cluster-Knoten laufen kontinuierlich über Jahre hinweg. Ungeplante Wartungsarbeiten an einem einzelnen Knoten zwingen dazu, laufende MPI-Jobs zu checkpointen, den ausgefallenen Knoten zu evakuieren und neu zu starten — ein Prozess, der bei einer groß angelegten Simulation Stunden an Rechenzeit über Hunderte von Knoten hinweg verschwenden kann. Dadurch wird die Zuverlässigkeit im Feld zum dominierenden Faktor bei den Total Cost of Ownership für Cluster-Computing-Installationen.Cluster-Zuverlässigkeits-Framework
- Erweiterte Komponentenqualifizierung: Elektrolytkondensatoren, die in der Spannung um 30 % und in der Temperatur um 20 % über die Nenngrenzwerte derated werden, MLCCs, die mindestens als X7R (C0G für timingkritische Schaltungen) spezifiziert sind, und MOSFETs, deren thermisches Rdson bei der Worst-Case-Sperrschichttemperatur eine Marge von 25 % über dem maximalen Dauerstrom einhält.
- SMT-Bestückung für verlängerte Lebensdauer: SAC305-Lötstellen werden durch 3.000+ thermische Zyklen nach IPC-9701 im tatsächlichen Betriebstemperaturbereich des Blades qualifiziert — das Dreifache der standardmäßigen 1.000-Zyklen-Qualifizierung, validiert durch Querschnittsanalyse und Zug-/Schertests nach den Zyklen.
- Prädiktive Fehlererkennung: BMC-Sensorschnittstellen überwachen VRM-Phasenströme, Kondensator-ESR (durch Impedanzmessung), DIMM-Fehlerraten (durch ECC-Zähler) und thermische Trends — und ermöglichen so den geplanten Austausch sich verschlechternder Komponenten vor dem Ausfall während geplanter Wartungsfenster.
- Im Feld wartbare Architektur: Modulares Board-Design mit zugänglichen Testpunkten für Vor-Ort-Diagnosen mit Standard-Multimeter und Oszilloskop — was es Tier-2-Feldtechnikern ermöglicht, ausgefallene Subsysteme zu identifizieren, ohne Boards an den Hersteller zurücksenden zu müssen.
Integrierte Blade- und Midplane-Fertigung
Cluster-Programme folgen strukturierten Build-Sequenzen — 5-10 Board-Bring-Up-Läufe für die Firmware-Entwicklung, 50-200 Board-Piloten für die Systemintegration und 500-10.000+ Produktions-Builds für den Kunden-Einsatz. Die einzigartige fertigungstechnische Herausforderung beim Cluster Computing besteht darin, dass Blade-PCBs und Midplane-/Backplane-PCBs zusammen mit einer koordinierten Maßkontrolle gefertigt werden müssen, da die Steckerverbindung zwischen Blade und Midplane davon abhängt, dass beide Boards gleichzeitig ihre jeweiligen Toleranzspezifikationen erfüllen.Koordinierte Produktion
- Prototyp Bring-Up: 5-10 Blade-Boards und passende Midplane-Sektionen, geliefert in 5-7 Werktagen mit vollständiger Komponentenbeschaffung — was die gleichzeitige Entwicklung der Blade-Firmware und Midplane-Integrationstests ermöglicht.
- Midplane Co-Fabrication: Sowohl Blade-PCBs als auch Midplane-/Backplane-Boards werden mit koordinierter Überprüfung der Steckerausrichtung gefertigt — Multilayer-Backplane-Boards (bis zu 40+ Lagen) mit Presspassungs-Steckerlöchern bei ±1,5 mil Positionstoleranz, verifiziert gegen die passenden Blade-Connector-Footprints.
- Turnkey Scaling: Automatisierte Bestückung mit ICT, Boundary Scan, Funktionstest und Burn-in — Aufrechterhaltung der Blade-zu-Blade-Konsistenz über Produktionschargen hinweg, die sich über Monate der Kundenbereitstellung erstrecken.
- Connector-Verifizierung auf Systemebene: Messung der Steckkraft und Verifizierung des Kontaktwiderstands an Blade-Midplane-Connectorpaaren — Gewährleistung einer zuverlässigen elektrischen Verbindung über die 50.000+ Steckzyklen, die während der Lebensdauer des Systems erwartet werden.
Cluster-Computing-PCB FAQ
Warum stehen Blade-Server-PCBs vor extremen Routing-Herausforderungen?
Blade-Server-PCBs haben ein extremes Seitenverhältnis (z. B. 30x500 mm), was bedeutet, dass Hochgeschwindigkeitssignale wie PCIe x16 oder DDR5 lange Strecken zurücklegen müssen. Diese Länge verbraucht das Einfügedämpfungsbudget aggressiv und zwingt zur Verwendung von ultra-verlustarmen Materialien und einer präzisen Impedanzkontrolle, um die Signalintegrität von der CPU bis zum Backplane-Connector aufrechtzuerhalten.
Wie wird die Stromversorgung auf GPU-dichten Cluster-Blades gemanagt?
Ein Cluster-Blade mit mehreren GPUs kann 2.500-4.000W verbrauchen. Um dies effizient zu managen, verwenden Boards eine 48V-Direct-to-Load-Umwandlungsarchitektur mit Intermediate Bus Convertern, die auf dedizierten Starkkupfer-Power-Layern geroutet sind, um den IR Drop zu minimieren und hohe Stromtransienten bei GPU-Lastspitzen zu bewältigen.
Warum müssen Blade-PCBs und Midplane-PCBs zusammen gefertigt werden?
Eine zuverlässige Verbindung zwischen einem Blade und einer Midplane ist auf eine präzise Steckerausrichtung angewiesen. Die Co-Fertigung beider Platinen stellt sicher, dass die Blade-Connector-Footprints und die Presspassungslöcher der Midplane koordinierte Maßtoleranzen erfüllen und so ein sicheres Stecken und elektrische Kontinuität garantieren.
Starten Sie Ihr Cluster-System-PCB-Programm — fordern Sie eine Blade-Board-Bewertung an →