

Le marché mondial du calcul par GPU a atteint 52,4 milliards de dollars en 2024, les charges de travail d'entraînement et d'inférence de l'IA entraînant une augmentation de 38 % d'une année sur l'autre de la demande en cartes accélératrices. Le calcul parallèle exécute des milliers d'opérations simultanément — les GPU traitent des couches de réseaux de neurones sur 16 384 cœurs CUDA, les FPGA exécutent des pipelines d'inférence personnalisés à la vitesse du réseau (wire speed), et les processeurs à puces multiples (chiplet) divisent les simulations de dynamique des fluides sur plus de 128 threads. Le PCB de Calcul Parallèle doit fournir une bande passante mémoire extrême dépassant 3 To/s, une alimentation de plusieurs centaines de watts avec une impédance du réseau de distribution d'énergie (PDN) inférieure au milliohm, et une intégrité du signal pour les interfaces 112G PAM4 — le tout dans des contraintes thermiques et mécaniques qui poussent la fabrication de PCB à ses limites absolues.
Le boom de l'entraînement de l'IA a fait des PCB de calcul parallèle le segment à la croissance la plus rapide dans la fabrication de cartes hautes performances. Les cartes accélératrices NVIDIA H100/H200 et AMD MI300X nécessitent des constructions de 20 à 32 couches avec un laminage HDI séquentiel, des plans d'alimentation en cuivre épais de 4 à 6 onces, et des pertes de canal suffisamment faibles pour supporter la signalisation 112G PAM4. HILPCB fabrique des PCB de calcul parallèle jusqu'à 64 couches — incluant des cartes de 28 couches avec 6 onces de cuivre transportant plus de 800 A vers les boîtiers des processeurs — pour les équipementiers d'accélérateurs GPU et FPGA et les intégrateurs de systèmes déployant des infrastructures d'entraînement IA et HPC dans des centres de données à travers le monde.
Navigation dans le Menu
- Pourquoi le Calcul Parallèle Crée des Exigences PCB Extrêmes
- Architecture de Distribution d'Énergie pour les Cartes Accélératrices de 700W+
- Routage de l'Interface Mémoire HBM3e et GDDR7
- Intégrité du Signal des Interconnexions PCIe Gen 5/Gen 6 et CXL
- Architecture Thermique à Pleine Charge Soutenue
- DFM pour la Fabrication de Cartes Accélératrices de 20 à 32 Couches
- Fabrication de PCB de Calcul Parallèle HILPCB
Pourquoi le Calcul Parallèle Crée des Exigences PCB Extrêmes
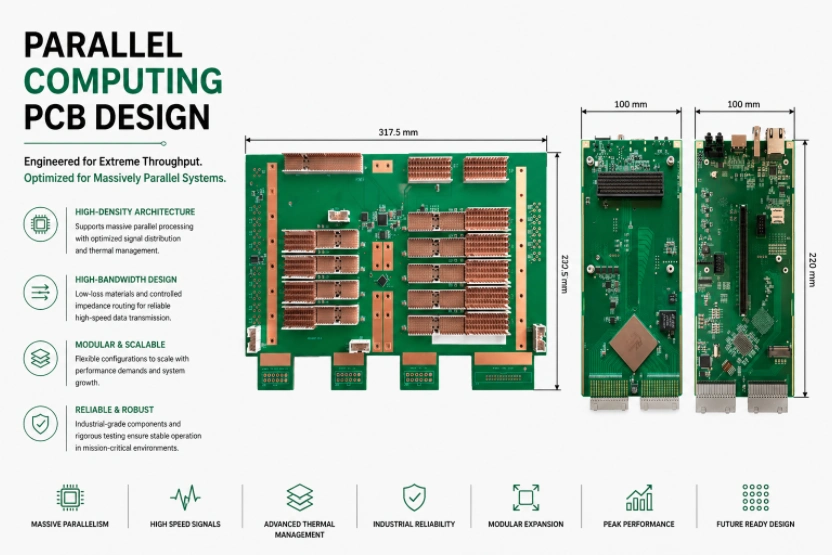
Un accélérateur GPU de la génération actuelle concentre 700W de puissance, 3,35 To/s de bande passante mémoire HBM3e et 128 voies de PCIe Gen 5/CXL 2.0 sur un seul PCB mesurant environ 267×112 mm. Ces exigences se combinent dans chaque domaine de conception de manière simultanée — la distribution d'énergie, l'intégrité du signal, la gestion thermique et la stabilité mécanique fonctionnent toutes à leurs limites physiques absolues avec une marge d'erreur nulle pour la variabilité de fabrication.Le défi technique ne réside pas dans un seul paramètre pris isolément — c'est l'interaction entre eux. Les plans en cuivre épais requis pour une alimentation de 800 A créent des discontinuités d'impédance qui interfèrent avec le routage adjacent du signal 112G PAM4. Les matrices de vias thermiques nécessaires à l'extraction de la chaleur consomment les canaux de routage requis pour l'échappement (escape) du HBM3e. Les zones de placement des inductances du module de régulation de tension (VRM) multiphasé entrent en conflit avec les zones d'exclusion (keepout) des bus mémoire haute vitesse. Résoudre ces interactions nécessite une revue de conception coordonnée multi-domaines que peu de fabricants ont l'expertise d'exécuter.
Le programme de PCB de calcul parallèle d'HILPCB relève ces défis cumulatifs par une co-conception puissance-signal-thermique simultanée — identifiant et résolvant les conflits entre les géométries des plans d'alimentation, les canaux de routage haute vitesse et les matrices de vias thermiques avant qu'ils n'atteignent la fabrication.
Les Défis Caractéristiques de la Conception de PCB de Calcul Parallèle
- Concentration de Puissance : Plus de 800 A à des tensions de cœur inférieures à 0,75 V avec une ondulation (ripple) < 5 mV sous des transitoires de 200 A/μs — nécessitant des VRM de 16 à 24 phases avec des plans en cuivre épais (4 à 6 onces en interne) qui ne doivent pas créer de discontinuités d'impédance pour le routage de signal 112G adjacent.
- Bande Passante Mémoire aux Limites du Substrat : Interfaces HBM3e à 9,6 Gbps par broche sur des bus de 1024 bits, et GDDR7 à 36 Gbps par broche utilisant la signalisation PAM4 — des débits de données où la perte diélectrique (Df) du PCB et la rugosité du cuivre sont les principaux facteurs limitant la bande passante, et non la vitesse du silicium.
- Stress Mécanique Sous Charge Thermique : Gauchissement de la carte (warpage) inférieur à 0,3 % de la diagonale sous une charge thermique soutenue de 700 W — évitant la perte de contact avec le matériau d'interface thermique (TIM), la fatigue des soudures BGA et le débranchement des connecteurs PCIe pendant des cycles d'entraînement s'étalant sur plusieurs jours.
- Complexité de Fabrication à Grande Échelle : 20 à 32 couches mélangeant la lamination HDI séquentielle avec des vias traversants, des plans d'alimentation en cuivre épais de 4 à 6 onces et un routage de signal trace/espacement de 3/3 mil sur des diélectriques à très faible perte (ultra-low-loss) — des défis de rendement exigeant une expertise en fabrication qui élimine le taux de rebut de 30 à 40 % typique des fabricants moins performants.
Ces exigences font des PCB de calcul parallèle l'une des cartes commerciales les plus techniquement difficiles à fabriquer — et les plus coûteuses lorsque la qualité de fabrication n'est pas au rendez-vous.
Architecture de Distribution d'Énergie pour les Cartes Accélératrices de 700W+
Le matériel parallèle consomme des niveaux de puissance rivalisant avec ceux des équipements industriels — un GPU d'entraînement tire 700W en continu pendant des jours lors de l'entraînement de grands modèles linguistiques (LLM), une matrice FPGA soutient 400W indéfiniment pendant le transcodage vidéo en temps réel, et les accélérateurs de nouvelle génération prévus sur la feuille de route dépassent 1000W par carte. Une alimentation propre à ces niveaux détermine si l'accélérateur atteint son débit TFLOPS nominal ou s'il se bride (throttle) sous une chute de tension (voltage droop) induite par des transitoires, ce qui peut réduire les performances d'entraînement de 15 à 20 %.Le défi de conception du PDN (Réseau de Distribution d'Énergie) est fondamentalement différent de celui des cartes de serveurs standard. Une puce GPU exécutant une multiplication matricielle sur l'ensemble de ses 16 384 cœurs crée des transitoires de courant dépassant 200 A/μs — suffisamment rapides pour que même des plans d'alimentation bien conçus présentent des chutes de tension à moins que le profil d'impédance du PDN ne soit plat, du courant continu (DC) jusqu'à 500 MHz. Cela exige non seulement du cuivre épais, mais aussi des géométries de plans conçues avec précision et un placement de découplage validé par simulation électromagnétique à ondes complètes.
Ingénierie du PDN pour les Accélérateurs Parallèles
- Disposition VRM Multiphase : Convertisseurs abaisseurs (buck) de 16 à 24 phases avec des étages de puissance DrMOS et des inductances placés à moins de 2 mm des billes d'alimentation (power balls) du circuit intégré. Boucles de courant de phase routées sur des couches de cuivre épais (4 à 6 onces en interne, 6 à 10 onces en externe sur des modules d'alimentation dédiés) maintenant l'inductance de boucle en dessous de 80 pH par phase.
- Partitionnement des Plans d'Alimentation sur des Couches Dédiées : Plans de cuivre séparés et ininterrompus pour la tension de cœur (0,65-0,85 V), les E/S HBM (1,05 V), le SerDes (0,9 V) et les rails auxiliaires — chacun sur des plans multicouches dédiés sans aucune pénétration de via de signal. Les géométries anti-pad (dégagements) autour des vias de signal sont optimisées via un solveur de champ 3D pour éviter les pics d'impédance localisés dans les plans d'alimentation.
- Découplage Distribué par Cible d'Impédance : 400 à 800 condensateurs placés selon une simulation d'impédance du PDN à ondes complètes — et non selon un placement empirique — maintenant l'impédance du PDN en dessous de 0,5 mΩ du DC jusqu'à 500 MHz. Les connexions via depuis les pastilles des condensateurs vers les plans d'alimentation/masse utilisent des via-in-pad avec des stubs (tronçons de via) forés à l'envers (back-drilled) pour minimiser la contribution ESL.
- Télémétrie de Courant en Temps Réel : Réseaux de résistances shunt de haute précision (tolérance de ±0,5 %, connexion Kelvin à 4 bornes) sur chaque rail principal fournissant une mesure de puissance en temps réel avec une précision de ±1 % — intégrés à la gestion de l'infrastructure du centre de données via PMBus/I²C pour le plafonnement de la puissance du GPU et la coordination du bridage (throttling) thermique.
Processus Validé d'Intégrité de l'Énergie
Chaque carte d'accélérateur subit une mesure d'impédance du PDN à l'aide d'un analyseur de réseau vectoriel (VNA) de 100 Hz à 1 GHz — vérifiant que la carte fabriquée respecte le profil d'impédance cible simulé sur toutes les décades de fréquences. Les cartes ne respectant pas le gabarit d'impédance sont rejetées avant l'assemblage des composants, évitant ainsi la découverte coûteuse de problèmes d'intégrité de l'énergie lors de l'intégration du système.
Routage de l'Interface Mémoire HBM3e et GDDR7
Les processeurs parallèles atteignent leur débit en accédant à la mémoire via des bus extrêmement larges et extrêmement rapides. L'HBM3e utilise des interfaces de 1024 bits à 9,6 Gbps par broche, offrant 1,2 To/s par pile (4,8 To/s sur quatre piles) ; la GDDR7 utilise des bus de 256 bits à 36 Gbps par broche utilisant la signalisation PAM4. Ces interfaces mémoire de nouvelle génération définissent le nombre de couches de la carte, le système de matériaux et la complexité du processus de fabrication — et poussent les substrats de PCB organiques à leurs limites physiques fondamentales.À ces débits de données, le PCB n'est pas une interconnexion passive — il contribue activement au taux d'erreur binaire (BER) du canal mémoire. La perte diélectrique (Df), la rugosité de surface du cuivre (Rz) et la résonance des stubs de vias (vias stubs) contribuent chacune à une dégradation mesurable de l'ouverture de l'œil (eye opening). Un processus de fabrication produisant une variation de Df de ±0,001 à 15 GHz — bien en deçà des tolérances standard — peut décaler la marge de l'œil GDDR7 de ±15 %, franchissant potentiellement la limite de conformité JEDEC.
Techniques de Routage Mémoire pour les Interfaces de Nouvelle Génération
- Intégration Interposer HBM3e : Plus de 2000 billes BGA au pas de 0,55 mm — plus serré que les générations HBM précédentes — nécessitant une construction HDI avec lamination séquentielle, des microvias empilés (percés au laser à 0,075 mm) et un trace/espacement de 2/2 mil pour le routage de sortie (escape routing). Le via-in-pad avec remplissage de cuivre et planarisation est obligatoire pour cette densité de billes.
- Intégrité du Signal GDDR7 PAM4 : La signalisation PAM4 à 36 Gbps exige une perte d'insertion inférieure à 2,5 dB à 18 GHz de fréquence de Nyquist — nécessitant des stratifiés à très faible perte (Dk 3,0, Df 0,0015 à 10 GHz, tels que Panasonic Megtron 7 ou Isola I-Speed) avec une feuille de cuivre HVLP (Rz < 1,5 μm) et des paires différentielles à impédance contrôlée dont la longueur est appariée (length-matched) à ±0,5 mil par groupe d'octets.
- Simulation de Canal Pré-Routage : Des modèles de canaux à paramètres S complets extraits de l'empilement (stackup) proposé à l'aide de solveurs de champ électromagnétique 3D (pas d'approximations 2D) vérifient l'ouverture de l'œil par rapport aux exigences du gabarit JEDEC dans les cas les plus défavorables des processus (Df maximal, rugosité du cuivre maximale, épaisseur diélectrique min/max) avant la validation de la disposition (layout).
- Gestion de la Diaphonie (Crosstalk) aux Niveaux de Tension PAM4 : Les trois ouvertures de l'œil du PAM4 ont chacune un tiers de l'amplitude du NRZ — rendant la tolérance à la diaphonie 9,5 dB plus stricte que le NRZ pour un BER équivalent. L'extraction post-disposition confirme que le couplage proche (NEXT) et lointain (FEXT) entre les canaux GDDR7 adjacents reste inférieur à -35 dB, empêchant la gigue dépendante des données (data-dependent jitter) qui ferme les marges de l'œil PAM4 déjà étroites.
Intégrité du Signal des Interconnexions PCIe Gen 5/Gen 6 et CXL
Les accélérateurs communiquent avec les processeurs hôtes via PCIe Gen 5 à 32 GT/s, avec la Gen 6 à 64 GT/s et le CXL 3.0 émergeant sur les plateformes de nouvelle génération. Chaque génération réduit de moitié le budget de perte d'insertion et double la sensibilité aux discontinuités d'impédance — faisant du canal PCB l'élément limitant les performances qui détermine si le système atteint le débit théorique maximal ou se rabat sur des vitesses de liaison inférieures.PCIe Gen 6 introduit la signalisation PAM4 à la norme PCIe pour la première fois, réduisant le budget de perte du canal à environ 20 dB — dont le PCB ne doit pas consommer plus de 6 à 8 dB, y compris toutes les transitions de vias, les discontinuités des condensateurs de couplage CA et les interfaces des connecteurs. À la fréquence de Nyquist de 32 GHz, chaque décision de conception compte : une transition de via vers stripline sous-optimale ajoute 1 à 2 dB, et quatre de ces transitions dans un canal typique consomment la moitié de l'allocation de perte du PCB.
Optimisation des Canaux PCIe Gen 5/6
- Allocation du Budget de Perte : La Gen 5 alloue environ 28 dB de perte de canal totale, la partie PCB devant rester inférieure à 8–10 dB. La Gen 6 durcit cette exigence à environ 20 dB au total, avec la partie PCB en dessous de 6–8 dB — exigeant l'élimination des stubs de vias (forage arrière, ou back-drilling, laissant un résidu < 6 mil), un diélectrique à perte ultra-faible (Df < 0,002 à 15 GHz) et du cuivre HVLP sur toutes les couches de signal.
- Ingénierie de Transition des Vias : Chaque transition de couche ajoute 0,5 à 2,0 dB entre 16 et 32 GHz selon la géométrie du via. Les trous traversants avec forage arrière (back-drilled), les vias borgnes/enterrés (blind/buried vias) et les géométries anti-pad (dégagements) optimisées de via vers piste sont modélisés individuellement via une simulation électromagnétique 3D et vérifiés par mesure TDR sur des cartes de production.
- Prise en Charge de l'Extension de Mémoire CXL : Les liaisons CXL 2.0/3.0 partagent la couche physique PCIe mais exigent une tolérance à la gigue plus stricte — le protocole de cohérence de cache de CXL tolère moins la latence de retransmission que le modèle d'écriture affichée (posted write) de PCIe, rendant la marge d'intégrité du signal critique pour les architectures de mutualisation de mémoire (memory pooling) rattachées par CXL.
- Vérification de Conformité du Diagramme de l'Œil : Les cartes de présérie (first-article) subissent des mesures du diagramme de l'œil à 32 GT/s (Gen 5) et 64 GT/s (Gen 6) à l'aide d'un BERT (Bit Error Rate Tester) étalonné et d'un oscilloscope — confirmant que le canal de production respecte le gabarit de conformité avec une marge documentée. Les mesures de l'œil sont effectuées à la température de fonctionnement, et non seulement à température ambiante.
Architecture Thermique à Pleine Charge Soutenue
Les cartes de calcul parallèle fonctionnent à puissance maximale pendant des heures ou des jours — les cycles d'entraînement de LLM s'exécutent pendant des semaines, les tâches de rendu (rendering) maintiennent une utilisation maximale du GPU pendant des heures, et les simulations scientifiques tournent jusqu'à convergence. La conception thermique doit gérer une charge pleine soutenue à la température ambiante nominale (35 à 45 °C en entrée d'air du centre de données) sans bridage (throttling) ni dégradation de la durée de vie des composants en dessous du cycle de remplacement de 5 ans en centre de données.Le défi thermique sur les PCB de calcul parallèle n'est pas simplement la dissipation de puissance totale — c'est la densité de puissance. Une puce GPU de 700W mesure environ 800 mm², concentrant plus de 87 W/cm² à la surface de la puce. Le PCB doit conduire cette chaleur à travers le substrat du boîtier, au travers de l'interface TIM (matériau d'interface thermique), et jusque dans le dissipateur thermique (heatsink) ou la plaque froide (cold plate) — et tout espace, vide (void) ou gauchissement (warpage) dans ce chemin thermique crée un point chaud (hot spot) qui déclenche un bridage localisé et réduit le débit de calcul global.
Conception Thermique pour Charge Soutenue
- Architecture des Vias Thermiques du Processeur : Des matrices denses de vias thermiques (0,3 mm de diamètre, 1,0 mm d'espacement) situées sous les boîtiers GPU/FPGA connectent le champ de pastilles BGA du côté supérieur à la zone cuivrée (copper pour) du côté inférieur interfaçant avec les dissipateurs thermiques via le TIM. Le remplissage des vias (cuivre ou époxy conducteur) et la planarisation de la surface à ±10 μm garantissent un contact constant avec le TIM sur l'ensemble de l'empreinte du boîtier.
- Gestion Thermique des VRM : 16 à 24 phases d'inductance dissipant chacune 2 à 4W créent des sources de chaleur distribuées totalisant 30 à 60W de perte VRM. Le zonage du placement des composants maintient les composants VRM sur le bord opposé de la carte par rapport aux oscillateurs d'horloge sensibles à la température, aux références de tension et aux capteurs I²C — assurant une séparation thermique de ≥ 15 mm.
- Contrôle du Gauchissement sous Charge Thermique : Un gauchissement (warpage) de la carte maintenu en dessous de 0,3 % de la diagonale grâce à une distribution symétrique du cuivre sur toutes les couches, une séquence de lamination équilibrée et un choix de préimprégné/noyau (prepreg/core) à coefficient de dilatation thermique (CTE) apparié — évitant la perte de contact du TIM qui réduit la conductivité thermique d'un facteur 3 à 5 au point de séparation.
- Répartition Interne de la Chaleur (Heat Spreading) : Des plans internes de cuivre de 3 à 4 onces répartissent la chaleur latéralement à partir des empreintes concentrées des puces, réduisant la différence de température pic-à-moyenne dans la zone de montage du boîtier. Simulation thermique vérifiée par des mesures de thermographie IR sur des cartes de présérie sous charge soutenue.
DFM pour la Fabrication de Cartes Accélératrices de 20 à 32 Couches
Les PCB de calcul parallèle figurent parmi les cartes commerciales les plus complexes fabriquées : 20 à 32 couches mélangeant le laminage séquentiel HDI avec des vias traversants, des plans d'alimentation en cuivre épais côtoyant un routage de signaux à lignes fines (fine-line), et des matériaux à ultra-faible perte qui requièrent des profils de laminage spécialisés. Le rendement de fabrication (manufacturing yield) dépend entièrement de la discipline DFM (conception pour la fabrication) appliquée pendant la phase de design, et de la capacité du fabricant, validée par des données statistiques de processus, et non par des discours marketing.La capacité de fabrication de HILPCB s'étend jusqu'à 64 couches pour les constructions les plus exigeantes, avec des processus validés en production pour des cartes accélératrices de 28 à 32 couches atteignant un rendement du premier passage (first-pass yield) supérieur à 92 %. Notre examen DFM pour les cartes de calcul parallèle identifie les interactions de risques de fabrication que les vérifications automatisées standard des règles de conception (DRC) omettent : le couplage entre les forces de gauchissement dues au cuivre épais, la dérive de l'alignement lors de la lamination séquentielle, la précision positionnelle du forage arrière (back-drill), et la sensibilité de température de laminage des matériaux à très faible perte.
Processus DFM pour Cartes Accélératrices Complexes
- Alignement (Registration) lors de la Lamination Séquentielle : Une précision de ±1,5 mil d'une couche à l'autre (layer-to-layer) sur des assemblages séquentiels de 20 à 32 couches, vérifiée par mesure de cibles d'alignement par rayons X à chaque cycle de laminage — empêchant le décalage (misalignment) entre le via et la pastille sur les routages d'échappement (escape routes) HBM BGA à pas de 0,55 mm où un décalage de 2 mils provoque un circuit ouvert.
- Contrôle de Profondeur du Forage Arrière (Back-Drill) : Les stubs de via sont contrôlés à < 6 mil par un forage arrière aligné au laser avec une vérification de la profondeur en cours de processus (in-process) utilisant une mesure de section transversale (cross-section) tous les 50 panneaux — chaque millième de pouce (mil) de stub en excès crée une résonance quart d'onde qui produit une encoche (notch) dans la réponse en fréquence du canal.
- Analyse de l'Équilibre du Cuivre (Copper Balance Analysis) : La distribution des couches d'alimentation en cuivre épais (4 à 6 onces) est analysée pour la flexion/torsion (bow/twist) à l'aide de la modélisation par éléments finis — un cuivre asymétrique crée un gauchissement (warpage) supérieur à 0,5 % qui impacte à la fois la précision du placement des composants et le contact de l'interface thermique.
- Validation de la Compatibilité des Matériaux : Les empilements de matériaux mixtes (couches de signaux à très faible perte avec couches d'alimentation standard FR-4) sont validés pour leur compatibilité de laminage — l'inadéquation du coefficient de dilatation thermique (CTE) entre des matériaux dissemblables provoque une contrainte inter-couches (inter-layer stress) qui peut entraîner une délamination pendant les cycles thermiques (thermal cycling).
- Validation des Prototypes : Cartes de présérie (first articles) avec vérification électrique complète (TDR, VNA, diagrammes de l'œil), analyse de section transversale et caractérisation thermique avant de s'engager dans l'outillage de production — une étape cruciale lorsqu'une refabrication (respin) coûte plus de 80 000 $ et entraîne un retard de 8 à 10 semaines sur le planning.
Fabrication de PCB de Calcul Parallèle HILPCB
HILPCB fabrique des PCB de calcul parallèle pour les équipementiers d'accélérateurs GPU, les intégrateurs de FPGA, les sociétés d'infrastructures d'entraînement à l'IA et les opérateurs de centres de données en Amérique du Nord, en Europe et dans la région Asie-Pacifique.Nos capacités de fabrication pour les cartes de calcul parallèle incluent une lamination HDI séquentielle jusqu'à 64 couches avec un repérage (registration) de ±1,5 mil, des plans d'alimentation en cuivre épais de 4 à 6 onces avec un routage VRM multiphase supportant une fourniture de plus de 800 A, des diélectriques à très faible perte (Df < 0,002 à 15 GHz) pour PCIe Gen 5/6, CXL et GDDR7, une prise en charge de l'interposer HBM3e avec un routage d'échappement (escape routing) BGA au pas de 0,55 mm avec un trace/espacement de 2/2 mil, un contrôle du gauchissement (warpage) inférieur à 0,3 % sous une charge thermique soutenue, et une fabrication conforme à la classe 3 de la norme IPC-6012 avec une traçabilité complète des lots et une impédance du PDN vérifiée par VNA sur chaque carte de production.
Que vous développiez l'accélérateur GPU de nouvelle génération ou que vous adaptiez l'infrastructure d'entraînement de l'IA (scaling AI training infrastructure), notre équipe d'ingénieurs travaille aux côtés de votre groupe de conception depuis la définition de l'empilement (stackup) jusqu'à la montée en cadence de la production (production ramp) — s'assurant que la capacité de fabrication est validée avant l'engagement du layout (layout commitment), et non découverte pendant les tests du premier article (first-article testing).
FAQ sur les PCB de Calcul Parallèle
Comment les PCB de calcul parallèle gèrent-ils une distribution d'énergie de 800 A ?
Fournir plus de 800 ampères nécessite des plans internes en cuivre épais (4 à 6 onces) et des VRM (modules régulateurs de tension) de 16 à 24 phases placés aussi près que possible du processeur. Le réseau de distribution d'énergie (PDN) doit être conçu à l'aide d'une simulation électromagnétique 3D à ondes complètes (full-wave) pour maintenir l'impédance en dessous de 0,5 mΩ jusqu'à 500 MHz, empêchant ainsi la chute de tension (voltage droop) transitoire.
Pourquoi la longueur des stubs de vias est-elle critique pour les signaux 112G PAM4 ?
À 112G PAM4 (fréquence de Nyquist de 56 GHz), les stubs de vias (portions de vias non utilisées) agissent comme des antennes résonantes qui absorbent l'énergie du signal, créant de sévères encoches (notches) dans la réponse en fréquence du canal. Le forage arrière (back-drilling) pour ne laisser qu'un résidu de stub < 6 mils est obligatoire pour préserver l'étroitesse du diagramme de l'œil PAM4.
Qu'est-ce qui cause le gauchissement (warpage) de la carte dans les cartes accélératrices GPU ?
Le gauchissement est principalement causé par une distribution asymétrique du cuivre, en particulier les épaisses couches de cuivre utilisées pour les courants élevés, combinée aux cycles thermiques extrêmes des charges de travail de 700 W. Nous contrôlons le gauchissement à < 0,3 % en utilisant des empilements (stackups) parfaitement équilibrés, des coulages de cuivre (copper pours) symétriques et des matériaux à coefficient de dilatation thermique (CTE) apparié.
Demandez une révision technique pour votre programme de cartes accélératrices →