
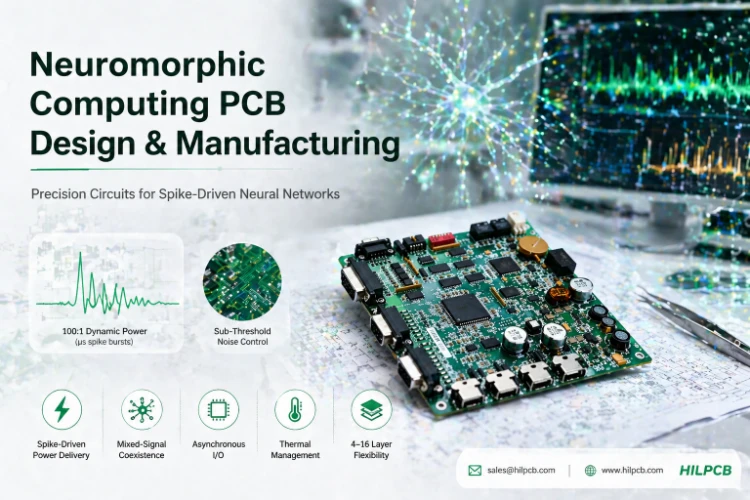
Intel的Loihi 2可在不到1W的功耗下处理实时感官数据。IBM的NorthPole在图像分类任务上的能效达到了领先GPU的12倍。BrainChip的Akida能以毫瓦级的功耗运行设备端学习。这些神经形态处理器(Neuromorphic processors)正大批量应用于自主机器人、卫星有效载荷、助听器以及工业检测等领域——而它们中的每一个都带来了标准数字电路板设计实践无法解决的PCB设计挑战:微秒内达到100:1的动态功率波动,对微伏级噪声极其敏感的亚阈值模拟神经元电路,以及没有时钟参考的异步事件驱动I/O。
HILPCB制造神经形态计算PCB的范围从4层研究评估板到16层生产载板——服务于芯片开发者、研究机构和产品公司,为全球汽车、国防、医疗和工业应用中部署类脑计算提供支持。
菜单导航
为什么神经形态芯片需要不同的PCB
传统的处理器在空闲和满载之间可能只在毫秒级的时间尺度内产生约2倍的波动。但神经形态的脉冲神经网络(SNN)处理器在微秒内会产生100倍的剧烈波动。在静止时,芯片的电流消耗为5 mA。当一阵脉冲(spike burst)在网络中传播时——例如由DVS相机的视觉事件、硅耳蜗的声音触发,或神经形态皮肤传感器的触觉接触所引发——电流会在不到10微秒内飙升至500 mA,然后在50微秒内回落。这是该处理器极其正常的运行模式。
这种由脉冲驱动的功率行为打破了传统PDN(电源输送网络)设计的假设。标准的去耦策略预设了平滑的电流包络线以及叠加在其上的高频噪声。而神经形态负载恰恰相反——其全部的功率需求本身就是“瞬态(transient)”的。
与此同时,许多神经形态架构采用在亚阈值(弱反型)区运行的晶体管,其信号电平在50–300 mV之间——比标准的CMOS数字逻辑对噪声的敏感度高出10–100倍。仅1 mV的电源噪声尖峰就会使有效的突触权重偏移5–10%,直接降低网络的分类准确率。PCB必须达到仪器级的噪声底噪,同时还要在同一块板上承载多千兆(multi-gigabit)的主机接口。
神经形态PCB设计有何不同
- 100:1的动态功率范围:PDN阻抗必须在5 mA到500 mA的连续负载变化中保持调节稳定——传统的在空闲和满载下进行的两点负载阶跃分析,对于由脉冲驱动的负载来说是远远不够的。
- 亚阈值噪声敏感性:模拟神经元电路需要低于100 μV(1 Hz–10 MHz频段)的板级噪声底噪——这要求其达到精密仪器PCB的标准,而不是普通的数字处理器载板。
- 宽带异步EMI:神经元内核之间无时钟的握手(handshaking)会产生扩频辐射(spread-spectrum emissions)——传统的时钟谐波滤波对这种噪声模式毫无作用。
- 多样的封装类型:来自初创公司和大学代工厂的芯片采用了从标准BGA到定制中介层(interposers)和板上芯片(COB)等各种形式——这需要极其灵活的PCB设计方法,而不是死板的数字布局套路。
针对脉冲驱动动态负载的电源输送
标准的多相VRM设计可达到100–300 kHz的带宽(3–10微秒的响应时间)。而神经形态的脉冲爆发在不到10微秒内就会到达。去耦网络必须在稳压器赶上来之前吸收掉全部的瞬态能量——且每秒发生数千次。
神经形态处理器的PDN架构
- 超宽带去耦:跨越6个频率十倍频程的三层电容器布局——100 μF的聚合物电容用于持续的脉冲爆发,以2 mm间距放置的1 μF MLCC用于中频响应,而在封装阴影内放置10–100 pF的电容用于脉冲开始时的极短瞬态。布局通过对实际脉冲活动模式的时域仿真来优化。
- 隔离的模拟LDO电源:为亚阈值神经元电源轨提供独立的LDO稳压器(在1 MHz下PSRR >70 dB)——在多层板(10–16层)上,在神经形态IC下方采用单点星形接地,将模拟和数字地平面连接起来。
- 自适应电压调节(AVS):具有PMBus/I²C电压编程和<5微秒设定点响应的VRM——在整个0.5–1.2V的动态电压范围内,保持PDN阻抗规范,以实现依赖于脉冲活动的电源管理。
- 实时电流遥测:在处理器核心供电轨上使用开尔文连接的精密分流电阻(±0.5%公差)进行高带宽(>1 MHz)的电流感测——支持实时监控脉冲活动并实现基于功耗感知的工作负载优化。
亚阈值神经元电路的混合信号走线
神经形态PCB设计的核心混合信号挑战,在于如何让亚毫伏级的极高模拟敏感度与同一块板上的多千兆位数字信号和平共处。50–300 mV的模拟神经元接口信号与USB 3.2 (10 Gbps)、千兆以太网 (GbE)、PCIe Gen 4主机接口、基于FPGA的脉冲排序逻辑,以及事件驱动的传感器总线共享电路板空间——这五个不同的信号域每一个都需要不同的阻抗、屏蔽和隔离处理。
神经形态电路板的混合信号布局
- 物理域分离:模拟神经元电路的电源、接地和信号走线被限制在专用的、具有连续地平面边界的板上区域。跨域连接通过带有铁氧体磁珠滤波的单点桥接进行——这可防止数字返回电流流经模拟地平面。
- 专用的地平面架构:在10–16层的结构中隔离模拟和数字地平面,仅在芯片内部模拟和数字地结合的神经形态IC下方的单个星形点处进行连接。沿着域边界以2 mm的间距进行过孔缝合(Via stitching),以防止形成缝隙天线谐振。
- 带状线(Stripline)信号隔离:模拟神经元接口走线布置在内部的带状线层上,上下均有接地屏蔽——与数字信号层实现>40 dB的隔离。模拟和数字信号之间至少保持5倍走线宽度的间距,对于更严苛的要求,还会使用接地缝合的保护走线(guard traces)。
- 静音区放置:亚阈值偏置发生器、电压基准以及模拟到脉冲转换器被放置在距离开关稳压器、振荡器和高速连接器最远的位置——元器件的放置方向经过精心调整,以将嘈杂节点和敏感节点之间的电容耦合降至最低。
事件驱动的传感器与I/O接口设计
神经形态处理器连接的事件驱动传感器(Event-driven sensors),其生成数据的方式与传统的基于帧的设备截然不同。动态视觉传感器(DVS事件相机,来自Prophesee、iniVation或Samsung)输出的是微秒级分辨率的异步像素事件,而不是同步的帧。硅耳蜗产生具有1微秒时间分辨率的脉冲编码音频。神经形态触觉传感器阵列在数百个触觉像素(taxels)上异步生成接触事件。
对于基于帧的系统而言,事件输入上10微秒的抖动微不足道——但在脉冲时序依赖可塑性(STDP)学习算法中(其中事件之间的时间相关性编码了信息),这样的抖动足以破坏学习算法。PCB接口必须在所有传感器通道上保留这种极其精准的时间精度。
事件接口PCB设计
- AER总线走线:地址事件表示(AER)总线在所有的地址线和握手线上需要有±0.5 ns的极低偏差匹配——在高速PCB层上采用LVDS或亚LVDS(sub-LVDS)信号传输,具备100Ω差分阻抗以控制传播延迟的变化。
- SPI/QSPI传感器链路:用于神经形态传感器配置和事件流的50–100 MHz SPI(例如BrainChip Akida,SynSense Speck/Xylo)——匹配的走线长度,时钟和数据线之间至少保持≥3倍的间距。
- 硬件时间戳同步:在所有的传感器接口上实现类似PTP的硬件时间戳(精度<1微秒)——分布式通用参考时钟,用于在单一的神经形态载板上实现融合事件相机+IMU+音频的多传感器融合。
- 主机接口域隔离:将USB 3.2或GbE主机连接放在专用的信号层上,并通过连续的地平面与神经形态处理域进行分离——坚决防止多千兆位(multi-gigabit)的开关切换污染亚毫伏级的神经电路。
应对毫瓦到瓦级功率波动的热设计
神经形态芯片通常的功耗<1W——但是载板上为其提供支持的电子元件(稳压器、I/O收发器、传感器接口、通信控制器)的功耗加起来却有5–15W之多。许多神经形态设备的部署目标——例如自主无人机、可穿戴医疗设备、工业检测摄像头——都是无风扇、电池供电并且非常紧凑的(例如40×60 mm),因此要求所有的热量提取都必须通过传导来实现。
紧凑型热架构
- 选择性热过孔策略:在稳压器和I/O收发器下方密集排列热过孔阵列——而不是在神经形态芯片下方。这颠覆了以往总是将散热管理集中在主处理器下方的传统热模式。
- 覆铜均热:在高Tg FR-4材料上使用2盎司的内层覆铜,将稳压器的热量分散到整个电路板面积上——对于面积<100×100 mm的板子来说,这种设计至关重要,因为集中的加热会产生30°C的局部热点。
- 电池供电效率:稳压器效率目标是在神经形态芯片典型的200 mW负载下>90%,而在2W爆发负载下>85%——从而最大限度地减少密封外壳内的废热。
- 工业级环境范围:经过1,500多次热循环验证的-40°C至+85°C的温度耐受能力——支持户外机器人、国防和交通等恶劣环境的部署。
从研究评估板到生产模块
神经形态计算的成熟度跨度异乎寻常的宽——从大学研究小组在班车上制作定制芯片(需要在10天内完成3块板以达成拨款里程碑),到BrainChip和SynSense出货成千上万个量产模块。HILPCB能够提供完全一致的低噪底噪和电源完整性标准来为这两端提供支持。
跨越成熟度阶段的制造
- 研究评估板:用于芯片Bring-up的2–10块板——包含板上芯片(COB)引线键合(wire bonding)、定制中介层、模拟探针接入和调试排针。5–7天即可快速周转交付。
- 开发平台:50–200块采用标准外形尺寸(例如COM Express载板、兼容Jetson)的板卡,并提供用于算法开发的、具有生产级信号完整性的硬件环境。
- 量产模块:1,000–10,000+个单元,配备自动化的SMT贴片组装、ICT测试、功能测试以及三防漆(conformal coating)涂覆——通过SPC控制的流程保持极其严格和经过验证的低噪底噪。
- 多芯片模块集成(MCM):将神经形态处理器 + 事件传感器 + 主机接口集成为一个单一模块,使用具备0.1 mm微盲孔和模拟级域隔离的HDI PCB。
常见问题解答
神经形态处理器的功耗曲线与标准的CPU有何不同? 传统的CPU拥有相对平滑的功率包络线以及叠加其上的高频噪声,然而脉冲神经网络(SNN)处理器在大部分时间里都处于空闲状态,但当它在处理一阵爆发的脉冲信号时,功耗会在不到10微秒内急剧飙升——往往会瞬间增加100倍之多。PCB的电源输送网络(PDN)在设计时必须确保能够吸收掉这些庞大、瞬间的瞬态电流,并且不能产生电压骤降。
为什么模拟走线对于神经形态芯片如此重要? 诸多神经形态架构采用了在50–300 mV极低电压下工作的亚阈值(sub-threshold)模拟电路。仅仅1 mV的噪声尖峰就会改变突触权重(synaptic weights),进而降低AI分类的准确率。这就要求PCB必须要保持仪器级别的超低噪声底噪,需采用带状线走线和极其孤立的地平面,将模拟神经元信号与多千兆位的数字接口进行重度隔离和屏蔽。
什么是事件驱动的传感器接口? 与以60 FPS固定捕捉帧画面的标准相机不同,神经形态传感器(例如DVS事件相机)采用异步输出机制,只有在像素发生变化时才输出数据,提供了极高的微秒级时间分辨率。PCB必须以极高的精度(亚纳秒级的偏差匹配)来对这些地址事件表示(AER)总线进行走线,以保留极度精确的脉冲时间点,这对于学习算法而言至关重要。
在紧凑的神经形态载板上是如何进行散热管理的? 尽管神经形态芯片本身的功耗可能还不到1W,但为其提供支持的电子元件(例如稳压器、I/O收发器、传感器)却可能产生5–15W的热量。由于许多边缘AI应用的设备都是无风扇且密封的,PCB就成为了主要的热沉(heatsink),通过采用厚重的内层覆铜以及位于稳压器下方密集的散热过孔阵列,将热量向四周横向发散。