
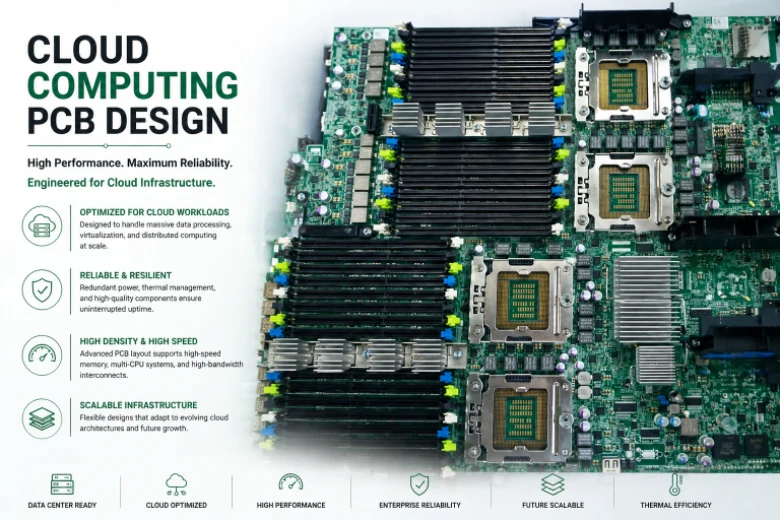
Der globale Markt für Cloud-Infrastrukturdienste erreichte 2024 330 Milliarden US-Dollar (Synergy Research), wobei AWS, Azure, Google Cloud und regionale Anbieter schätzungsweise 3 Millionen neue Server pro Jahr bereitstellen — jeder davon enthält Leiterplatten, die nach Hyperscale-Qualitätsstandards gefertigt sind, bei denen eine Ausfallrate der Platinen von 0,1 % zu 3.000 gleichzeitigen Ausfällen führt, die Support-Tickets, SLA-Strafen und Ersatzlogistik im globalen Maßstab generieren. Cloud Computing konzentriert massive Verarbeitungs-, Speicher- und Netzwerkkapazitäten in Hyperscale-Rechenzentren — und liefert Compute-as-a-Service durch Hardware, deren Leistung, Energieeffizienz und Zuverlässigkeit auf PCB-Ebene bestimmt werden.
Die Ökonomie von Cloud-Hardware unterscheidet sich grundlegend von Enterprise-Computing. Ein Hyperscaler, der Server-Mainboards evaluiert, fragt nicht "funktioniert dieses Board?" — er berechnet die Total Cost of Ownership (TCO) über Einsätze von 100.000 Einheiten, bei denen eine Stromeinsparung von 2W pro Server 200 kW Last eliminiert (175.000 /Jahr an Stromkosten), eine Zuverlässigkeitsverbesserung von 0,05 % 50 Vor-Ort-Austausche pro Jahr vermeidet (25.000 an Anfahrtskosten) und eine BOM-Reduzierung von 3 pro Board 300.000 pro Generation einspart. Jede PCB-Designentscheidung hat finanzielle Konsequenzen auf Flottenebene.
HILPCB fertigt Cloud-Computing-PCBs — und liefert 16-28-lagige Server-Boards in Volumina von über 5.000 Einheiten pro Monat mit einer Impedanzkonsistenz von Cpk >1,33 — für Server-OEMs, Storage-Anbieter und Netzwerkunternehmen, die weltweit die physische Infrastruktur des Cloud Computing aufbauen.
Menü-Navigation
- Cloud-Scale-Ökonomie auf Board-Ebene
- Server-Mainboard Signalintegrität: DDR5, PCIe Gen 5 und CXL
- NVMe-Storage-Controller und Plattformdesign
- 400G/800G Netzwerk-Switch und NIC-Fertigung
- Energieeffizienz und thermisches Design für maximale Rackdichte
- Volumenproduktion und Lieferkontinuität
Cloud-Scale-Ökonomie auf Board-Ebene
Kaufentscheidungen für Cloud-Hardware werden durch rigorose TCO-Modellierung über Bereitstellungszyklen von 3-5 Jahren getroffen. Die Leiterplatte wird nicht als isolierte Komponente bewertet — sie wird als Beitrag zur Leistung pro Watt, Zuverlässigkeit pro Dollar und Herstellkosten bei Skalierung bewertet. Unser Co-Design-Engagement mit OEMs von Cloud-Hardware optimiert diese TCO-Dimensionen von der anfänglichen Stackup-Definition bis zum Produktionsanlauf.Dimensionen der Cloud-PCB-Optimierung
- Leistung pro Watt: Maximaler Rechendurchsatz pro Watt des gesamten Systemstroms — Vorantreiben der Signalintegritätsoptimierung (Erreichen der vollen Schnittstellenbandbreite ohne Neuübertragungs-Overhead), VRM-Effizienz-Engineering (>93 % bei typischer Last) und Auswahl verlustarmer Materialien, die die dielektrische Erwärmung der PCB reduzieren.
- Zuverlässigkeit auf Flottenebene: 5-jährige kontinuierliche MTBF mit einer jährlichen Ausfallrate der Platinen von <0,1 % bei Flotten von 100.000 Einheiten — erreicht durch Komponenten-Derating (30 % Spannung, 20 % Temperatur bei Elektrolytkondensatoren), Qualifizierung der Lötstellen (2.500+ thermische Zyklen nach IPC-9701) und Materialeingangsprüfung zur Vermeidung latenter Fehler.
- Herstellkosten bei Volumen: BOM-Kostenoptimierung durch standardisierte passive Komponentenwerte (Reduzierung eindeutiger Teilenummern um 30-40 %), Maximierung der Nutzen-Ausnutzung (15-20 % Materialeinsparung durch optimiertes Array-Layout) und DFM-gesteuertes Design, das eine SMT-First-Pass-Ausbeute von >95 % erzielt.
- Wartungsfreundlichkeit und Remote-Management: Hot-Swap-Fähigkeit für im Feld austauschbare Einheiten, umfassende BMC-Sensor-Arrays mit Redfish API und Diagnose-LED-Anzeigen — wodurch die mittlere Reparaturzeit von Stunden auf Minuten reduziert wird und ein Headless-Rechenzentrumsbetrieb ermöglicht wird.
Server-Mainboard Signalintegrität: DDR5, PCIe Gen 5 und CXL
Cloud-Server-Mainboards übertragen gleichzeitig die schnellsten kommerziellen Schnittstellen: DDR5 mit 4800-6400 MT/s über 8-12 Kanäle, PCIe Gen 5 mit 32 GT/s über 128+ Lanes, CXL 2.0 zur Speichererweiterung und -bündelung sowie UPI/GMI für Multi-Socket-Interconnects mit 16-24 GT/s. Jede Schnittstelle hat Verlustbudgets, die der PCB nur minimale Spielräume lassen — und sie alle teilen sich dieselbe 16-28-lagige Board-Konstruktion und konkurrieren um optimale Routing-Lagen und Referenzebenen-Ressourcen.Server Signalintegritäts-Engineering
- DDR5 Routing bei 5600+ MT/s: 40Ω Single-Ended-Impedanz mit ±1 mil Byte-Lane-Anpassung und Fly-by-Topologie, simuliert für den Write-Leveling-Timing-Margin bei jeder unterstützten DIMM-Bestückung (1DPC und 2DPC). Der On-DIMM-Spannungsregler von DDR5 erfordert ein zusätzliches Stromversorgungs-Routing, das bei DDR4-Designs nicht vorhanden ist — VR12.5-Stromschienen, die zusammen mit den Speicherdatenbussen mit angemessener Isolierung geroutet werden.
- Multi-Socket Interconnect bei 24 GT/s: UPI 2.0 (Intel) und GMI3/Infinity Fabric (AMD) Links, die 6-12 Zoll zwischen Prozessorsockeln mit einer Einfügedämpfung von unter 8 dB bei 12 GHz überbrücken — erfordern verlustarme Laminate (Df < 0,004 bei 10 GHz) und back-gebohrte Vias mit <8 mil Stub auf 16-28-lagigen Konstruktionen.
- CXL 2.0 Speichererweiterung: CXL Type 3 Memory Expander-Schnittstellen, die sich die PCIe Gen 5 Physical Layer teilen — geroutet neben Standard-PCIe-Steckplätzen, erfordern jedoch eine engere Zuweisung des Jitter-Budgets, da das Cache-Kohärenz-Protokoll von CXL weniger tolerant gegenüber Latenzzeiten bei der Link-Level-Neuübertragung ist als gepostete PCIe-Schreibvorgänge.
- Produktions-Impedanz-Verifizierung: TDR-Impedanzmessung an Testcoupons aus jedem Produktionsnutzen, wobei die Einhaltung des Augendiagramms bei Erstmusterprüfungen bei DDR5 (5600 MT/s) und PCIe Gen 5 (32 GT/s) Datenraten mit kalibrierten BERT-Instrumenten verifiziert wird.
NVMe-Storage-Controller und Plattformdesign
Die Cloud-Speicherinfrastruktur baut auf NVMe SSDs auf, die hinter PCIe-Switch-ICs aggregiert sind — die Storage-Controller-PCB routet 16-96 Lanes PCIe Gen 4/5 vom Switch-ASIC zu SFF-8639-, E1.S- oder E3.S-Laufwerkssteckern, wobei jede Lane eine individuelle Impedanzkontrolle und Verlustverifizierung erfordert. Diese Platinen sind gleichzeitig Hochgeschwindigkeits-Digitaldesigns (PCIe bei 32 GT/s) und Power-Management-Herausforderungen (Switch-ICs, die 30-100W in eingeschränkten Formfaktoren ableiten).Storage-Controller-Board Design
- PCIe Fan-Out Routing: PCIe Gen 5 Switch-Fan-Out über Entfernungen von 100-300 mm auf Multilayer-Konstruktionen (14-20 Lagen) mit verlustarmen Laminat-Signallagen, Back-Drill-Via-Übergängen und optimierter Steckverbinder-Startgeometrie — wodurch der Kanalverlust innerhalb der Spezifikation über alle 16-96 Lanes hinweg gleichzeitig eingehalten wird.
- Koexistenz gemischter Protokolle: Dedizierte Routing-Lagen für PCIe (85Ω differenziell) und Legacy-SAS (100Ω differenziell) mit kontinuierlicher Masseebenenabschirmung zwischen den Protokollen — verhindert Übersprechen zwischen 32 GT/s PCIe- und 22,5 Gbps SAS-Signalen, das Bitfehler im Speicherdatenpfad verursachen würde.
- Controller-Wärmemanagement: Speicher-Switch-ICs, die 50-100W in HHHL- oder FHFL-Kartenformaten ableiten, mit thermischen Via-Arrays, Starkkupfer-Stromebenen (2-3 oz) und Bauteilplatzierung, die für eingeschränkten Luftstrom optimiert ist — hält die Sperrschichttemperatur unter anhaltenden zufälligen Schreib-Workloads mit 10°C Spielraum unter der Throttling-Schwelle.
- Per-Lane Augen-Verifizierung: Einhaltung des Augendiagramms, das bei jeder PCIe-Lane während der Erstmusterprüfung gemessen wird — da eine einzelne Lane mit marginalem Eye-Margin ein intermittierendes Link-Retraining erzeugt, das Speicher-IOPS und Tail-Latenz verschlechtert, wobei der Fehler eher als Speicherleistungsproblem denn als PCB-Defekt auftritt.
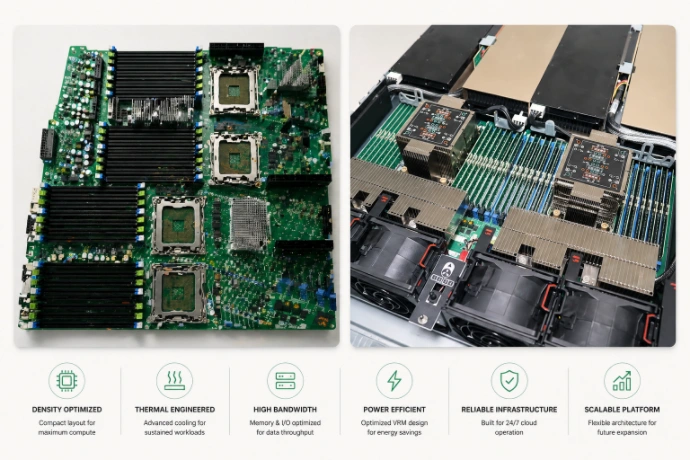
400G/800G Netzwerk-Switch und NIC-Fertigung
Cloud-Rechenzentren verbinden Server über 25G/100G/400G-NICs und Top-of-Rack-Switches, die Millionen von Paketen pro Sekunde verarbeiten. 800G-Switches der nächsten Generation verwenden 112G PAM4 SerDes (8×112G pro Port), wobei 224G PAM4 aufkommt — wodurch Boards entstehen, die gleichzeitig Herausforderungen für das Ultra-High-Speed-Digital- und das RF-Grade-Analogdesign darstellen. NIC-PCBs tragen Netzwerk-PHY-ICs mit 32-64 SerDes-Lanes, einer PCIe Gen 5 Host-Schnittstelle, QSFP-DD/OSFP-Steckverbinder-Arrays und einer ausgeklügelten Stromversorgung — alles auf Platinen mit einer Größe von 150×200 mm.Fertigungskapazitäten für Netzwerkplatinen
- 400G/800G Kanal-Design: 8×50G PAM4 (400G) oder 8×112G PAM4 (800G) pro Port mit Einfügedämpfung unter 5 dB bei 26,5 GHz (400G) oder unter 4 dB bei 56 GHz (800G) — Hochfrequenzlaminate (Dk 3.0, Df < 0,002 bei 28 GHz) auf Signallagen in Kombination mit Standard-FR-4 auf Power-/Ground-Lagen zur Kostenkontrolle in der Großserienfertigung.
- Switch ASIC BGA Escape: 5.000-7.000+ BGA-Pads mit Hunderten von 112G SerDes-Lanes erfordern HDI-PCBs mit sequentieller Lamination auf 24-36-lagigen Konstruktionen (Fähigkeit bis zu 64 Lagen). Lasergebohrte Microvias mit 0,075 mm und gestapelten Via-Strukturen für vollständigen ASIC-Escape innerhalb des Gehäuseschattens — jede SerDes-Lane individuell impedanzangepasst durch Via-Anti-Pad-Optimierung.
- NIC-Stromversorgung für Line-Rate-Verarbeitung: Netzwerk-PHY-ICs, die 25-50W von 0,75-1,0V-Kernstromversorgungen ziehen, mit mehrphasiger Regelung, die ±2 % Spannung bei Worst-Case-Line-Rate-Paketverarbeitung mit voller Verschlüsselung aufrechterhält — das VRM-Transientenverhalten ist für die Burst-Traffic-Muster ausgelegt, die für die Ost-West-Kommunikation im Rechenzentrum charakteristisch sind.
- EMI Pre-Compliance: Layout-integrierte EMI-Bewertung mit Nahfeldscans — Optimierung der Schlitzantennenstrahlung von Ebenenlücken, der Erdung der Steckerabschirmung und der Eindämmung von Taktoberwellen während des Board-Designs, anstatt Compliance-Probleme erst bei FCC/CE/VCCI-Zertifizierungstests zu entdecken.
Energieeffizienz und thermisches Design für maximale Rackdichte
Cloud-Rechenzentren sind grundsätzlich leistungsbeschränkt — jedes Watt, das durch PCB-Verluste (VRM-Ineffizienz, ohmscher Kupferverlust, dielektrische Erwärmung) verbraucht wird, reduziert die verfügbare Rechenkapazität. Auf Flottenebene summieren sich Verbesserungen der PCB-Energieeffizienz: Eine Verbesserung von 2W pro Server über 100.000 Server eliminiert 200 kW IT-Last und 60-100 kW proportionale Kühllast, was jährlich über 225.000 $ einspart.Effizienz und thermische Optimierung
- VRM-Effizienz-Profiling: Wandler-ICs werden für das spezifische Lastprofil (nicht nur die Spitzeneffizienz) ausgewählt und charakterisiert — mit dem Ziel >93 % bei typischer 50-70 %-Last, >88 % bei 10 % Leerlauflast und >90 % bei 100 % Dauerlast. Schaltfrequenz, Induktivitätsauswahl und Gate-Drive-Stärke, die für die lastgewichtete Effizienz über das tatsächliche Betriebsprofil des Servers optimiert sind.
- IR Drop Engineering: 3,3V- und 5V-Schienen, die 10-30A über 6-10 Zoll tragen, erfordern eine Kupferstärke, die pro Schiene berechnet und durch DC-IR-Drop-Simulation verifiziert wird — oft wird selektiv 2-3 oz Kupfer auf Hochstrom-Power-Layern innerhalb einer Standard-1-oz-Board-Konstruktion spezifiziert, um den ohmschen Verlust zu minimieren, ohne die Fertigungskosten über alle Lagen zu erhöhen.
- 1U Luftstrom-optimiertes Layout: Bauteilplatzierung, die in 1U-Servern mit 40-44 mm Gesamthöhenfreigabe ungestörte Luftstromkanäle vom vorderen Einlass zum hinteren Auslass schafft. Hohe Komponenten (VRM-Induktivitäten, Elektrolytkondensatoren) werden an stromabwärtigen Positionen platziert, wo sie vom vorgekühlten stromaufwärtigen Luftstrom profitieren, anstatt Blockaden für stromabwärtige Komponenten zu bilden.
- Thermisches Derating für Rechenzentrumsbedingungen: Komponentenauswahl mit Temperatur-Derating zur Gewährleistung eines zuverlässigen Betriebs bei 35°C Zuluft (ASHRAE A1-Klasse) und 45°C (ASHRAE A3/A4 für Free-Cooling-Rechenzentren) — die zunehmende Akzeptanz der freien Kühlung in Cloud-Rechenzentren erhöht die Umgebungstemperaturen über das hinaus, was herkömmliche Serverdesigns berücksichtigen.
Volumenproduktion und Lieferkontinuität
Die Produktion von Cloud-Hardware folgt bestimmten Mustern: 6-12 Monate Entwicklungszyklen, angetrieben durch neue Prozessorgenerationen, schnelle Produktionsanläufe von der Pilotphase bis zu Tausenden pro Monat innerhalb von 8-12 Wochen, anhaltende Builds bei Spitzenvolumen für 18-24 Monate und verwaltetes End-of-Life mit 12-monatigen Last-Time-Buy-Fenstern. Fertigungsagilität und Lieferkontinuität entscheiden darüber, ob ein OEM die Zeitpläne für den Ausbau von Rechenzentren einhält — eine Verzögerung von 4 Wochen bei der Serverlieferung kann die Bereitstellung eines 50-Millionen-Dollar-Rechenzentrums um ein ganzes Quartal verschieben.Produktions- und Supply-Chain-Framework
- Rapid Prototyping: Erste Entwicklungsboards in 5-7 Werktagen für Hardware-Bring-up, BIOS-Entwicklung und Firmware-Validierung — wodurch Hardware-Teams mit der Systemintegration beginnen können, während die Produktionswerkzeuge finalisiert werden.
- Pilotproduktions-Qualifizierung: Läufe von 100-500 Boards, die Fertigungsprozessparameter, Ausbeute-Baselines und Testabdeckungsmetriken festlegen — Pilot-Boards, die für Systemqualifizierung, regulatorische Zertifizierung und Kundenbemusterung verwendet werden.
- Volumenanlauf auf 5.000+/Monat: Automatisierte SMT-Bestückung mit In-Circuit-Test (ICT), Boundary Scan (JTAG) und funktionaler Verifizierung — Produktionslinie qualifiziert für konsistente Qualität bei Spitzenvolumen mit Echtzeit-SPC-Überwachung bei kritischen Prozessen.
- Lieferkontinuitätsplanung: Pufferbestand für Komponenten mit über 6 Wochen Lieferzeit, qualifizierte Second Sources für alle Single-Sourced ICs und proaktives End-of-Life-Management mit 18-monatiger Vorankündigung — Schutz mehrjähriger Produktionsprogramme vor Unterbrechungen der Komponentenversorgung.
Cloud-Computing-PCB FAQ
Was sind die wichtigsten Herausforderungen bei der Signalintegrität in Cloud-Server-Mainboards?
Cloud-Server-Mainboards müssen gleichzeitig Hochgeschwindigkeits-Schnittstellen wie DDR5 (5600+ MT/s), PCIe Gen 5 (32 GT/s) und CXL 2.0 routen. Dies erfordert eine strikte Impedanzkontrolle, verlustarme Laminatmaterialien und fortschrittliche Via-Strukturen (wie Back-Drilling), um die Einfügedämpfung zu minimieren und die Signalintegrität über 16-28-lagige Board-Konstruktionen hinweg zu erhalten.
Wie wirkt sich das PCB-Design auf die Energieeffizienz von Rechenzentren aus?
Die PCB-Energieeffizienz skaliert direkt über Tausende von Servern. Das Design für minimalen IR Drop durch den Einsatz von Starkkupfer-Stromebebenen und die Optimierung der Voltage Regulator Module (VRM)-Effizienz kann Watt pro Server einsparen, was sich bei der Bereitstellung von Hyperscale-Rechenzentren in Einsparungen von Hunderten von Kilowatt niederschlägt.
Warum ist das Wärmemanagement für NVMe-Speichercontroller so kritisch?
NVMe PCIe-Switch-ICs können 50-100W innerhalb begrenzter Formfaktoren ableiten. Effektive thermische Via-Arrays, Starkkupfer-Ebenen zur lateralen Wärmeverteilung und eine optimierte Bauteilplatzierung sind erforderlich, um die Sperrschichttemperaturen unter den Throttling-Schwellen zu halten und anhaltende Speicher-IOPS zu gewährleisten.
Vereinbaren Sie ein Cloud-Hardware-Co-Design-Review mit unserem Engineering-Team →