
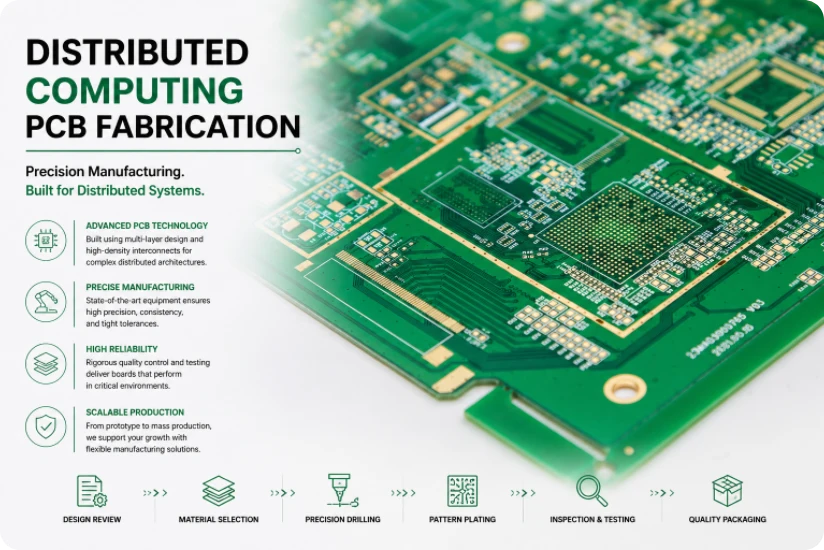
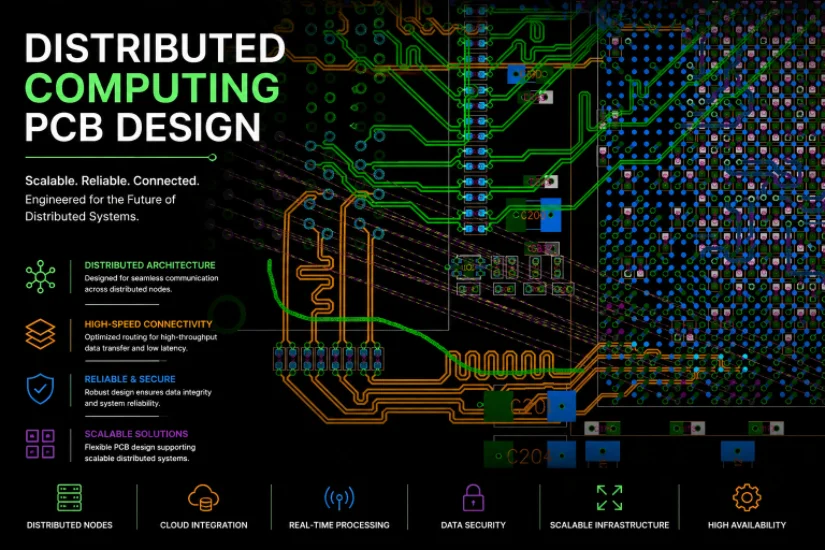
Der globale Markt für verteiltes Rechnen (Distributed Computing) überstieg 2024 die Marke von 5,8 Milliarden US-Dollar. Blockchain-Infrastrukturen, Content Delivery Networks (CDNs) und wissenschaftliches Rechnen treiben die Nachfrage nach konsistenter PCB-Fertigung auf Flottenebene an – und das bei Stückzahlen, bei denen Fertigungsabweichungen zu einem Leistungsproblem auf Systemebene werden. Beim Distributed Computing werden Arbeitslasten (Workloads) auf Dutzende bis Tausende von miteinander verbundenen Knoten verteilt. Jeder Knoten verfügt über einen eigenen Prozessor und Speicher und koordiniert sich über Hochgeschwindigkeits-Netzwerkverbindungen unter Verwendung von Protokollen (MPI, gRPC, libp2p, RAFT-Konsens), die extrem empfindlich auf Leistungsschwankungen zwischen den Knoten reagieren. Die Distributed Computing PCB in jedem Knoten darf nicht nur eine individuelle Leistung erbringen — sie muss über jede Platine in der Flotte hinweg eine identische Leistung erbringen, da der langsamste Knoten in einem verteilten System zum Flaschenhals für den gesamten Cluster wird.
Diese Anforderung an Konsistenz verändert das Paradigma der Fertigungsqualität grundlegend. Ein Standard-Server-Mainboard wird einzeln bewertet: Erfüllt diese Platine die Spezifikation? Eine Distributed-Computing-Platine wird statistisch bewertet: Entspricht die Leistungsverteilung dieses Produktionsloses jedem vorherigen Los? Eine Impedanzabweichung von 3 %, die zwar individuelle Board-Spezifikationen erfüllt, aber die Leistung von Knoten zu Knoten verschiebt, führt bei verteilten Workloads zu einem "Nachzügler-Problem" (Straggler Problem) — ein einziger langsamer Knoten, der eine MapReduce-Barrieren-Synchronisierung aufhält, verschwendet bei jedem Synchronisierungsereignis Tausende von CPU-Sekunden im gesamten Cluster.
HILPCB hat Distributed-Computing-Platinen in Losgrößen von 10 bis 8.000 Stück mit einer Impedanzkonsistenz von Cpk >1,33 und <0,5 % Schwankung der PDN-Impedanz (Power Delivery Network) über Produktionslose hinweg, die sich über 18 Monate erstrecken, geliefert — die Wiederholbarkeit auf Populationsebene, die dezentrale Systeme in Flottengröße erfordern.
Menü-Navigation
- Warum Flottenkonsistenz wichtiger ist als Einzelspezifikationen
- Netzwerk-Interconnect-Design für 25G/100G RDMA
- Taktsynchronisation und Speicherarchitektur
- Leistungs- und Wärmemanagement für den Dauerbetrieb
- Statistische Fertigungsqualität auf Flottenebene
- Vom Pilotlauf zur 5.000-Board-Produktion
Warum Flottenkonsistenz wichtiger ist als Einzelspezifikationen
Jeder Knoten in einem verteilten System muss austauschbar sein — im Betrieb muss jede Platine identisch mit jeder anderen funktionieren. In einem Blockchain-Validierungsnetzwerk hängt die Konsenslatenz vom langsamsten Validator ab. In einem CDN wird die SLA (Service Level Agreement) für die Bereitstellung von Inhalten durch den Edge-Knoten mit der schlechtesten Leistung festgelegt. In einem wissenschaftlichen MapReduce-Cluster wird die Barrieren-Synchronisationszeit durch den letzten Knoten begrenzt, der seine Partition abschließt.Dies bedeutet, dass die Fertigungskonsistenz über die bloße Einhaltung individueller Platinenspezifikationen hinausgeht und die primäre Qualitätsmetrik darstellt. Impedanzabweichungen zwischen Platinen verändern die Signalausbreitungsgeschwindigkeit (Signal Propagation Velocity) und verursachen Zeitunterschiede zwischen den Knoten. Impedanzabweichungen in der Stromversorgung (Power Delivery) erzeugen Spannungseinbruchsprofile (Voltage Droop Profiles) von Knoten zu Knoten, die zu unterschiedlichem CPU-Boost-Takt-Verhalten führen. Abweichungen in der thermischen Performance führen zu unterschiedlichen Drosselungsschwellen (Throttling Thresholds) in der gesamten Flotte.
Konsistenzkritische Fertigungsparameter
- Impedanz-Populationskontrolle: SPC-Tracking (Statistical Process Control) für jedes kontrollierte Impedanznetzwerk in jedem Produktionslos — nicht nur individuelle Pass/Fail-Kriterien für Platinen, sondern eine Population Cpk >1,33 mit Drifterkennung, die Prozessanpassungen auslöst, bevor eine Platine die Spezifikation verlässt. Historische Trenddaten, die über Lose hinweg gepflegt werden, ermöglichen eine langfristige Konsistenzanalyse.
- Gleichmäßigkeit der Kupfergewichte: ±5 % Gleichmäßigkeit der Kupferdicke über alle Lagen innerhalb eines Panels und über Panels innerhalb eines Loses — dies gewährleistet eine von Platine zu Platine konsistente Stromversorgungs-Impedanz (Kupfergewicht bestimmt direkt den Flächenwiderstand) und thermische Leistung (Kupfervolumen bestimmt die Wärmespreizungskapazität).
- Konsistenz im Montageprozess: SMT-Bestückung mit ±25 μm Genauigkeit und 100% Post-Placement-AOI, die die gleichmäßige Bauteilausrichtung auf impedanzempfindlichen Pads verifiziert — eine Verschiebung von 50 μm bei der Positionierung eines 0402-Entkopplungskondensators verändert seinen ESL-Beitrag zum PDN in messbaren Mengen auf Flottenebene.
- Serialisierte Rückverfolgbarkeit: Jede Platine wird mit dem Laminatlos, der Kupferfoliencharge, der Ätzchemiecharge, dem Reflow-Profil-Zeitstempel und dem vollständigen Testdatensatz serialisiert. Dies ermöglicht eine Ursachenanalyse (Root-Cause Analysis), die Leistungsschwankungen im Feld mit spezifischen Fertigungsparametern in einer eingesetzten Flotte von Tausenden von Geräten korreliert.
Netzwerk-Interconnect-Design für 25G/100G RDMA
Der Netzwerkdurchsatz und die Latenz bestimmen die Leistung dezentraler Systeme direkter als die reine Rechengeschwindigkeit. Ein Knoten mit 20 % mehr Rechenleistung, aber 10 % höherer Netzwerklatenz verlangsamt bei kommunikationsintensiven Workloads den gesamten Cluster. Moderne verteilte Knoten verwenden 25GbE oder 100GbE mit RDMA over Converged Ethernet (RoCE v2) für Kernel-Bypass-Netzwerke, was den Overhead des Software-Stacks eliminiert und die Latenz von 50 μs (Kernel-TCP) auf <2 μs (Hardware-RDMA) reduziert.Der PCB-Netzwerkpfad vom PCIe Root Complex der CPU durch Leiterbahnen, Vias und Steckverbinder bis zum NIC PHY ist das leistungskritischste Subsystem auf jeder Distributed-Computing-Platine – und das Subsystem, das am empfindlichsten auf Fertigungsschwankungen zwischen den Platinen reagiert.
Netzwerk-Schnittstellen-Engineering
- 25G/100G SerDes Routing: Differentielle Paare mit 25,78 Gbaud (NRZ für 25G) oder 26,5625 Gbaud (PAM4 für 100G) mit einer Einfügedämpfung von unter 6 dB bei Nyquist-Frequenz auf inneren Stripline-Lagen — 100Ω ±5% differentielle Impedanz mit <1,5 mil Intra-Pair-Skew. Der Aufbau einer High-Speed PCB mit Mid-Loss-Laminaten (Df ≤ 0,005 bei 12,5 GHz) reicht für 25G aus; für 100G sind Low-Loss-Laminate (Df ≤ 0,003) erforderlich.
- SFP28/QSFP28 Connector Layout: Connector-to-PHY-Routing gemäß SFF-8402 (SFP28) und SFF-8665 (QSFP28) Richtlinien — maximal 130 mm Leiterbahnlänge für 25G, wobei die Via-Übergänge auf 2 pro differentiellem Paar begrenzt sind und Via-Stubs durch Back-Drilling auf <8 mil kontrolliert werden.
- RDMA Latenzoptimierung: Eine deterministische Latenz durch den Hardwarepfad erfordert die Beseitigung von Impedanzdiskontinuitäten und Stub-Resonanzen, die Intersymbolinterferenz (ISI) erzeugen — ISI verschlechtert nicht nur den Augenrand (Eye Margin), sondern erzeugt auch datenabhängige Latenzschwankungen (Jitter), die die von der verteilten Anwendung beobachtete "Tail Latency" im 99. Perzentil direkt erhöhen.
- Press-Fit Backplane-Steckverbinder: Hochgeschwindigkeits-Differentielle Press-Fit-Steckverbinder erfordern Bohrungstoleranzen von ±2 mil auf Multilayer-Platinen, wobei die kontrollierte Impedanz durch die gesamte Steckverbinder-Übergangszone aufrechterhalten wird — kritisch für verteilte Systeme, die Backplane-Architekturen mit Shared Storage oder Network Switching verwenden.
Taktsynchronisation und Speicherarchitektur
Verteilte Systeme erfordern eine präzise zeitliche Koordination zwischen Knoten für die Reihenfolge von Ereignissen, Transaktionssequenzierung und synchronisierte Datenerfassung. Finanzhandelsplattformen (Financial Trading) erfordern Mikrosekunden-Synchronisation (PTP mit Hardware-Timestamping), die industrielle verteilte Steuerung benötigt Sub-Millisekunden (PTP oder NTP) und das wissenschaftliche Rechnen benötigt synchronisiertes Sampling über Cluster-Knoten hinweg für zeitkorrelierte Datenanalysen.Die Taktarchitektur der Platine — Auswahl des Referenzoszillators, Taktverteilungstopologie und Implementierung von PTP-Hardware-Timestamping — bestimmt direkt die erreichbare Synchronisationsgenauigkeit.
Timing- und Speichersystemdesign
- IEEE 1588v2 Hardware Timestamping: Der PTP-Takteingang wird auf impedanzkontrollierten Leiterbahnen mit einer Längenanpassung (Length Matching) von ±3 mil zwischen Referenztakt und Zeitstempel-Latch (Timestamp Latch) geroutet — wodurch eine Synchronisationsgenauigkeit von <100 ns mit Hardware-Zeitstempeln erreicht wird, im Gegensatz zu >1 ms bei reiner Software-NTP. Für Finanzanwendungen, die <1 μs erfordern, wird ein dedizierter PTP-Grandmaster-Clock-Eingang mit OCXO-Holdover (±5 ppb) bei GPS-Signalverlust eingesetzt.
- Auswahl und Isolierung von Referenzoszillatoren: TCXO (±0,5 ppm, -40 bis +85 °C) für Standard-Distributed-Computing, OCXO (±5 ppb) für Finanz- und wissenschaftliche Anwendungen, die Sub-Mikrosekunden-Synchronisation erfordern. Thermisch isolierte Montage mit >15 mm Abstand zu wärmeerzeugenden Komponenten und eine gefilterte Stromversorgung, die verhindert, dass Schaltgeräusche die Oszillatorfrequenz beeinflussen.
- DDR5-Speicher-Routing für rechenintensive Workloads: 4–8 Kanäle DDR5 mit 4800–5600 MT/s mit Fly-by-Topologie, ±1 mil Byte-Lane-Anpassung und Pre-Layout-Simulationen, die Write-Leveling-Timing-Margen bei allen DIMM-Bestückungskonfigurationen verifizieren. Validierte Signalintegrität für sowohl 1DPC- als auch 2DPC-Konfigurationen auf High-Speed-Laminaten mit kontrollierter Dk-Toleranz (±3%).
- Verlöteter LPDDR5 für kompakte Knoten: Für dichte verteilte 1U-Knoten, die LPDDR5 mit 6400 MT/s verwenden, bietet eine HDI-PCB mit Via-in-Pad, 0,075 mm Microvias und 3/3 mil Trace/Space die Routingdichte, die für 0,5-mm-Pitch-Package-Escape bei ±15 μm Registrierungsgenauigkeit erforderlich ist.
Leistungs- und Wärmemanagement für den Dauerbetrieb
Verteilte Knoten laufen 24/7/365 für 5–10 Jahre unter anhaltender Rechenlast. Im Gegensatz zu Edge-Geräten mit intermittierenden Nutzungsmustern oder Cloud-Servern mit variablen Multi-Tenant-Workloads behalten Distributed Computing Nodes, die Blockchain-Validierungen, CDN-Content-Processing oder wissenschaftliche Batch-Workloads ausführen, kontinuierlich eine nahezu maximale Verlustleistung bei. Ein thermisches Design, das nur 5°C Marge über der Dauertemperatur bietet, führt zu vorzeitiger Bauteilalterung, Lötstellenermüdung und schließlich zu Ausfällen im Feld, die das gesamte verteilte System beeinträchtigen.Design für den Dauerbetrieb
- Heavy Copper für die Energieverteilung (Power Distribution): Multi-Core-Prozessoren, die 125–350W TDP ziehen, erfordern Multi-Phasen-VRMs mit Heavy-Copper-Lagen (2–4 oz intern), um IR-Drops und ohmsche Erwärmung unter Dauerlasten zu minimieren. Die Kupferdicke wird pro Versorgungsschiene (Rail) berechnet — oft wird selektives schweres Kupfer spezifiziert (3 oz auf den Vcore-Lagen des Prozessors, 1 oz auf den I/O-Lagen) innerhalb eines einzigen Platinenaufbaus, um die Stromversorgungskapazität mit den Signal-Routing-Anforderungen in Einklang zu bringen.
- Architektur für thermische Vias: Gefüllte und mit Kappen versehene thermische Vias (Filled and Capped Thermal Vias, IPC-4761 Typ VII) unter dem Prozessor und den VRM-Leistungsstufen mit 0,3 mm Durchmesser und 0,8 mm Pitch. Diese leiten die Wärme an die Kühlkörper auf der Unterseite ab, ohne dass beim Montieren Lot abgesaugt wird (Solder Wicking). Das Material zur Via-Füllung (Kupfer oder wärmeleitfähiges Epoxidharz) wird auf Basis der Anforderungen an die Wärmeleitfähigkeit für die TDP des spezifischen Prozessors ausgewählt.
- Materialauswahl für jahrzehntelangen Service: High-Tg FR-4 (Tg ≥ 175 °C, Td ≥ 350 °C) wurde auf Langzeitstabilität bei dauerhaften Betriebstemperaturen durch 10.000 Stunden beschleunigte Alterung (Accelerated Aging) validiert. Die CAF-Beständigkeit (Conductive Anodic Filament) wird durch einen 1.000-stündigen Test bei 85 °C/85 % RH bei Nennspannung validiert, um Fehler durch elektrochemische Migration zu verhindern, die Platinen nach 3–4 Jahren im Dauerbetrieb zerstören.
- Haltbarkeit der Lötstellen: SAC305-Lötverbindungen, die für 3.000+ thermische Zyklen gemäß IPC-9701 unter kontinuierlichen Leistungsbedingungen validiert wurden — dies übertrifft die standardmäßige 1.000-Zyklen-Qualifikation für ständig eingeschaltete dezentrale Infrastrukturen um das Dreifache.
Statistische Fertigungsqualität auf Flottenebene
Fertigungsabweichungen, die in der Einzelplatinenproduktion unsichtbar sind, wirken sich im Maßstab des Distributed Computing auf das System aus. Eine Impedanzverschiebung (Impedance Drift) von 3 % zwischen Produktionslosen verändert das Verhalten des CPU-Boost-Takts. Eine Variation des Kupfergewichts um 5 % verändert den thermischen Widerstand. Eine subtile Abweichung im Reflow-Profil erzeugt eine Population von Platinen mit geringfügig schwächeren Lötverbindungen, die 18 Monate vor dem Rest der Flotte ausfallen.Qualitätskontrolle im Flottenmaßstab
- Echtzeit-SPC für Produktionsparameter: Automatisierte SPC-Dashboards verfolgen Impedanz (TDR auf jedem Panel), Kupfergewicht (Mikroschliff bei jedem Los), Bohrlochregistrierung (Röntgenprüfung), Ätzfaktor (Etch Factor) und Lotpastenvolumen — mit "Western Electric"-Regeln, die Prozesstrends 2–3 Lose früher erkennen, bevor sie Platinen außerhalb der Spezifikation produzieren würden.
- Verifizierung eingehender Materiallose: Dk/Df-Messung an jedem eingehenden Laminatlos unter Verwendung eines Split-Post-Dielectric-Resonators bei 10 GHz — Materiallose, deren dielektrische Eigenschaften die kontrollierte Impedanz außerhalb des Designziels verschieben würden, werden abgelehnt, selbst wenn das Material technisch seiner eigenen Datenblattspezifikation entspricht.
- Festlegung des Montageprozesses (Lock) nach Qualifikation: Reflow-Temperaturprofile, Pick-and-Place-Programme, Lotpastentyp und Schablonendesign sowie Inspektionskriterien werden nach der Qualifizierung des Pilotloses formell festgelegt. Jede Änderung, einschließlich eines Wechsels der Pastencharge, erfordert eine formelle Neuqualifizierung, um unbeabsichtigte Prozessverschiebungen (Process Drift) zu verhindern.
- Pilot-Produktionsvalidierung: Pilotläufe mit 50–200 Platinen mit vollständiger elektrischer Charakterisierung, Impedanzpopulationsanalyse und beschleunigten thermischen Tests – zur Validierung von Fertigungsprozessen und zur Quantifizierung der Ausbeute (Yield), bevor mit dem vollen Produktionsvolumen begonnen wird.
Vom Pilotlauf zur 5.000-Board-Produktion
Distributed Computing auf Flottenebene erfordert Teststrategien, die systematische Fertigungsprobleme vor der Bereitstellung erkennen — denn ein latenter Fehler in 1 % der Platinen bedeutet 50 ausfallende Knoten in einem 5.000-Knoten-Cluster. Jeder dieser Ausfälle löst Workload-Rebalancing, Datenmigration und Service-Verschlechterung aus.Teststrategie und Produktionsskalierung
- 100% Boundary Scan (JTAG): Überprüft die Integrität der Lötverbindungen bei jedem BGA-, QFN- und Fine-Pitch-Bauteil — unerlässlich für hochdichte Leiterplatten (High-Density Boards), bei denen verdeckte Lötstellen optisch nicht inspiziert werden können.
- Verifizierung der Signalintegrität an Erstmustern (First Articles): TDR-Impedanzprofilierung und Augendiagrammmessung mit tatsächlichen Datenraten (25G NRZ, DDR5) auf Erstmusterplatinen — dies bestätigt, dass die Leistung der Produktionskanäle mit den Pre-Layout-Simulationszielen übereinstimmt.
- 48–72 Stunden Elevated-Temperature Burn-In: Dauerbetrieb bei 55°C Umgebungstemperatur (statt 35°C Nennwert) unter künstlicher Rechenlast belastet frühzeitige Ausfallmechanismen (Infant-Mortality) — dies stellt sicher, dass eingesetzte Platinen den frühen Fehlerbereich der "Badewannenkurve" (Bathtub Curve) bereits hinter sich gelassen haben.
- Turnkey Flotten-Produktion: Integrierte Beschaffung, Fertigung, Montage, Tests, Burn-In, Serialisierung und Logistik für flottenweite Bereitstellungen — Aufrechterhaltung gleichbleibender Qualität und Rückverfolgbarkeit vom 10-Platinen-Pilot bis zur 8.000-Platinen-Produktion.
Distributed Computing PCB FAQ
Warum ist Impedanzkonsistenz für Flotten im Distributed Computing so wichtig?
In einem Distributed-Computing-Cluster bestimmt der langsamste Knoten die Gesamtleistung. Abweichungen der PCB-Impedanz innerhalb einer Flotte können die Signalausbreitungsgeschwindigkeiten (Signal Propagation Velocities) verändern und Zeitunterschiede von Knoten zu Knoten erzeugen. Die Gewährleistung einer hohen statistischen Konsistenz (Cpk >1,33) garantiert identische Leistung über Tausende eingesetzter Platinen hinweg.
Was sind die PCB-Anforderungen für RDMA-Netzwerk-Interconnects?
RDMA-Netzwerke (wie 25G/100G RoCE) erfordern ultraniedrige Latenzzeiten und minimalen Paketverlust. Die Leiterplatte muss verlustarme Laminate (Low-Loss Laminates), präzises differentielles Paar-Routing (z. B. 100Ω ±5%) und back-drilled Vias verwenden, um Stub-Resonanzen zu beseitigen. Dies verhindert Intersymbolinterferenzen (ISI), die Jitter und Latenzspitzen (Latency Spikes) verursachen.
Wie gehen PCBs für dezentrale Knoten mit anhaltenden thermischen Belastungen um?
Im Gegensatz zu Standard-Servern laufen verteilte Knoten (Distributed Nodes) oft fast am Leistungsmaximum, 24/7. Ihre PCBs erfordern starke interne Kupferschichten (Heavy Copper, 2-4 oz) zur lateralen Wärmeverteilung, dichte Anordnungen thermischer Vias unter Hochleistungsbauteilen und High-Tg-Materialien, um langfristige dielektrische Verschlechterungen unter kontinuierlichem thermischen Stress zu verhindern.
Holen Sie sich Preise für Flottengrößen für Ihr Distributed Computing-Programm ein →