

Der globale Markt für GPU-Computing erreichte im Jahr 2024 52,4 Milliarden US-Dollar, wobei KI-Trainings- und Inferenz-Workloads für einen Anstieg der Nachfrage nach Beschleunigerkarten von 38 % gegenüber dem Vorjahr sorgten. Parallel Computing führt Tausende von Operationen gleichzeitig aus — GPUs verarbeiten neuronale Netzwerkschichten über 16.384 CUDA-Kerne, FPGAs führen benutzerdefinierte Inferenz-Pipelines mit Wire-Speed aus, und Multi-Die-Chiplet-Prozessoren unterteilen Fluiddynamik-Simulationen in 128+ Threads. Das Parallel Computing PCB muss eine extreme Speicherbandbreite von über 3 TB/s, eine Stromversorgung (Power Delivery) im Multi-Hundert-Watt-Bereich mit Sub-Milliohm PDN-Impedanz und Signalintegrität für 112G PAM4-Schnittstellen liefern — und all dies innerhalb thermischer und mechanischer Einschränkungen, die die Leiterplattenfertigung an ihre absoluten Grenzen bringen.
Der KI-Trainingsboom hat Parallel-Computing-Leiterplatten zum am schnellsten wachsenden Segment in der High-Performance-Boardfertigung gemacht. NVIDIA H100/H200 und AMD MI300X Beschleunigerkarten erfordern 20-32-lagige Konstruktionen mit sequenzieller HDI-Lamination, 4-6 Unzen Dickkupfer-Stromversorgungsebenen und Kanaldämpfungen, die gering genug sind, um 112G PAM4-Signalisierung zu unterstützen. HILPCB fertigt Parallel-Computing-Leiterplatten mit bis zu 64 Lagen — einschließlich 28-lagiger Boards mit 6 Unzen Kupfer, die über 800 A an Prozessorgehäuse liefern — für GPU- und FPGA-Beschleuniger-OEMs sowie Systemintegratoren, die KI-Trainings- und HPC-Infrastrukturen in Rechenzentren weltweit bereitstellen.
Menü-Navigation
- Warum Parallel Computing extreme PCB-Anforderungen schafft
- Power Delivery-Architektur für 700W+ Beschleunigerkarten
- HBM3e- und GDDR7-Speicherschnittstellen-Routing
- PCIe Gen 5/Gen 6 und CXL Interconnect Signalintegrität
- Thermische Architektur für anhaltende Volllast
- DFM für die Fertigung von 20–32 Lagen Beschleunigerboards
- HILPCB Parallel Computing PCB-Fertigung
Warum Parallel Computing extreme PCB-Anforderungen schafft
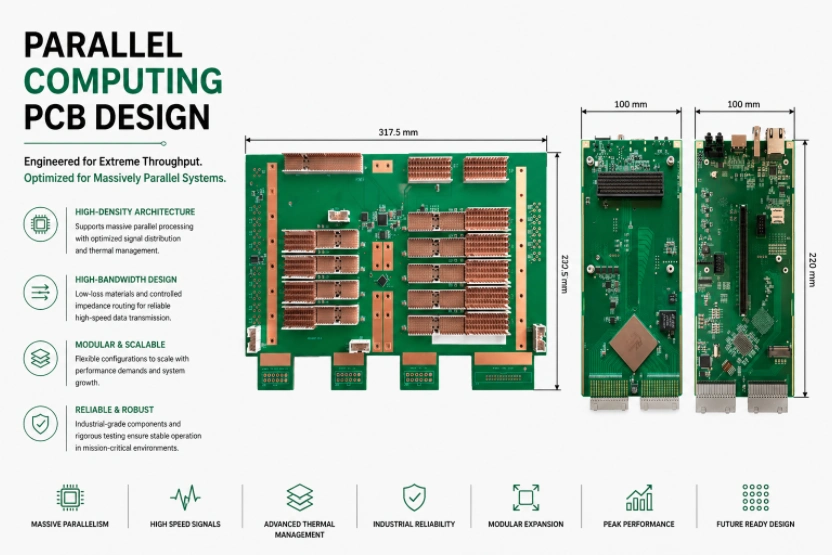
Ein GPU-Beschleuniger der aktuellen Generation konzentriert 700 W Leistung, 3,35 TB/s HBM3e-Speicherbandbreite und 128 Lanes von PCIe Gen 5/CXL 2.0 auf eine einzige Leiterplatte mit Abmessungen von etwa 267×112 mm. Diese Anforderungen kumulieren sich über jede Design-Domäne hinweg gleichzeitig — Stromversorgung, Signalintegrität, Wärmemanagement und mechanische Stabilität arbeiten an ihren absoluten physikalischen Grenzen ohne jede Marge für Fertigungsabweichungen.Die technische Herausforderung liegt nicht in einem einzelnen, isolierten Parameter — es ist die Wechselwirkung zwischen ihnen. Dickkupferebenen, die für eine 800-A-Stromversorgung erforderlich sind, erzeugen Impedanzdiskontinuitäten, die benachbartes 112G PAM4-Signal-Routing stören. Thermische Via-Arrays (Thermal Vias), die für die Wärmeabfuhr benötigt werden, verbrauchen Routing-Kanäle, die für das HBM3e-Escape-Routing (Fan-out) unerlässlich sind. Zonen für die Platzierung von Mehrphasen-VRM-Induktivitäten (Spulen) kollidieren mit Keepout-Bereichen für Hochgeschwindigkeits-Speicherbusse. Die Lösung dieser Interaktionen erfordert eine koordinierte, domänenübergreifende Designüberprüfung, für deren Umsetzung nur wenige Leiterplattenhersteller über die nötige Expertise verfügen.
Das Parallel-Computing-PCB-Programm von HILPCB adressiert diese sich verstärkenden Herausforderungen durch simultanes Power-Signal-Thermal Co-Design — Konflikte zwischen Power-Plane-Geometrien, High-Speed-Routing-Kanälen und Thermal-Via-Arrays werden identifiziert und gelöst, bevor sie in die Fertigung gelangen.
Definierende Herausforderungen im Parallel Computing PCB-Design
- Leistungskonzentration: Über 800 A bei Core-Spannungen von unter 0,75 V mit <5 mV Ripple (Restwelligkeit) bei 200 A/μs Transienten — was 16–24 Phasen-VRMs (Spannungsreglermodule) mit Dickkupferebenen (4–6 Unzen intern) erfordert, die keine Impedanzdiskontinuitäten für das angrenzende 112G Signalrouting verursachen dürfen.
- Speicherbandbreite an der Grenze des Substrats: HBM3e-Schnittstellen mit 9,6 Gbps pro Pin über 1024-Bit-Busse und GDDR7 mit 36 Gbps pro Pin unter Verwendung von PAM4-Signalisierung — Datenraten, bei denen dielektrische PCB-Verluste (Df) und Kupferrauigkeit die primären Bandbreitenbegrenzer sind, nicht die Geschwindigkeit des Siliziums.
- Mechanischer Stress unter thermischer Last: Eine Board-Verwölbung (Warpage) von unter 0,3 % der Diagonale unter einer dauerhaften thermischen Last von 700 W — dies verhindert den Verlust des Kontakts zum Thermal Interface Material (TIM), Ermüdung der BGA-Lötstellen und das Lösen von PCIe-Steckverbindern während mehrtägiger Trainingsläufe.
- Fertigungskomplexität bei Skalierung: 20–32 Lagen, die sequenzielle HDI-Lamination mit Through-Hole Vias, 4–6 Unzen Dickkupfer-Stromebenen und 3/3 mil Trace/Space Signal-Routing auf Ultra-Low-Loss-Dielektrika mischen — Ertragsprobleme (Yield Challenges), die eine Fertigungsexpertise erfordern, welche die typische Ausschussquote von 30–40 % weniger fähiger Hersteller eliminiert.
Diese Anforderungen machen Parallel-Computing-PCBs zu den technisch anspruchsvollsten kommerziellen Platinen, die überhaupt hergestellt werden — und zu den kostenintensivsten, wenn die Fertigungsqualität unzureichend ist.
Power Delivery-Architektur für 700W+ Beschleunigerkarten
Parallele Hardware zieht Leistung in Größenordnungen, die mit Industrieanlagen vergleichbar sind — eine Trainings-GPU zieht während des Trainings von großen Sprachmodellen (LLMs) ununterbrochen 700 W über Tage hinweg, ein FPGA-Array hält während Echtzeit-Videotranscodierung auf unbestimmte Zeit 400 W aufrecht, und Beschleuniger der nächsten Generation auf der Roadmap überschreiten 1000 W pro Karte. Eine saubere Stromversorgung auf diesen Niveaus bestimmt, ob der Beschleuniger seinen bewerteten TFLOPS-Durchsatz erreicht oder unter transient-induziertem Voltage Droop (Spannungseinbruch) throttelt, was die Trainingsleistung um 15–20 % reduzieren kann.Die Herausforderung im PDN-Design (Power Delivery Network) unterscheidet sich grundlegend von Standard-Server-Boards. Ein GPU-Die, der eine Matrixmultiplikation über alle 16.384 Kerne ausführt, erzeugt Stromtransienten, die 200 A/μs überschreiten — schnell genug, damit selbst gut designte Power Planes einen Spannungsabfall aufweisen, es sei denn, das PDN-Impedanzprofil ist von DC bis 500 MHz absolut flach. Dies erfordert nicht nur massives Kupfer, sondern präzise konstruierte Ebenengeometrien mit einer Entkopplungs-Platzierung (Decoupling Placement), die durch Full-Wave Elektromagnetik-Simulation (3D EM) validiert wurde.
PDN-Engineering für parallele Beschleuniger
- Mehrphasiges VRM-Layout: 16–24-phasige Buck-Konverter (Abwärtswandler) mit DrMOS-Leistungsstufen und Induktivitäten, die innerhalb von 2 mm zu den IC-Power-BGA-Balls platziert sind. Phasenstromschleifen, die auf Dickkupfer-Lagen geroutet sind (4–6 Unzen intern, 6–10 Unzen extern auf dedizierten Power-Modulen), halten die Schleifeninduktivität (Loop Inductance) auf unter 80 pH pro Phase.
- Partitionierung von Stromebenen (Power Planes) auf dedizierten Lagen: Separate, ununterbrochene Kupferebenen für die Core-Spannung (0,65–0,85V), HBM I/O (1,05V), SerDes (0,9V) und Hilfsschienen — jede auf dedizierten Multilayer-Ebenen ohne Durchdringungen durch Signalvias. Anti-Pad-Geometrien um Signal-Vias werden durch 3D-Feldlöser (Field Solver) optimiert, um lokalisierte Impedanzspitzen in den Power Planes zu verhindern.
- Verteilte Entkopplung nach Impedanz-Zielvorgabe: 400–800 Kondensatoren werden basierend auf Full-Wave PDN-Impedanzsimulation platziert — keine Daumenregel-Platzierung —, um die PDN-Impedanz von DC bis 500 MHz unter 0,5 mΩ zu halten. Via-Verbindungen von Kondensatorpads zu den Power-/Ground-Planes nutzen Via-in-Pad mit Back-drilled Stubs, um den ESL-Beitrag (Äquivalente Serieninduktivität) zu minimieren.
- Echtzeit-Stromtelemetrie: Hochpräzise Shunt-Widerstandsnetzwerke (±0,5 % Toleranz, 4-Leiter-Kelvin-Anschluss) auf jeder Hauptstromschiene bieten Echtzeit-Leistungsmessung mit ±1 % Genauigkeit — integriert in das Management der Rechenzentrumsinfrastruktur über PMBus/I²C für GPU Power Capping und die Koordination thermischen Throttlings.
Validierter Power Integrity Prozess
Jede Beschleunigerplatine durchläuft eine PDN-Impedanzmessung unter Verwendung eines Vektor-Netzwerkanalysators (VNA) von 100 Hz bis 1 GHz — um zu verifizieren, dass das gefertigte Board über alle Frequenzdekaden hinweg dem simulierten Ziel-Impedanzprofil entspricht. Boards, die an der Impedanzmaske scheitern, werden vor der Bauteilbestückung ausgesondert, was die kostspielige Entdeckung von Power Integrity-Problemen während der Systemintegration verhindert.
HBM3e- und GDDR7-Speicherschnittstellen-Routing
Parallelprozessoren erreichen ihren Durchsatz, indem sie über extrem breite und extrem schnelle Busse auf den Speicher zugreifen. HBM3e verwendet 1024-Bit-Schnittstellen mit 9,6 Gbps pro Pin und liefert 1,2 TB/s pro Stack (4,8 TB/s über vier Stacks); GDDR7 verwendet 256-Bit-Busse bei 36 Gbps pro Pin unter Verwendung von PAM4-Signalisierung. Diese Next-Generation Speicherschnittstellen definieren die Lagenanzahl des Boards, das Materialsystem und die Komplexität des Fertigungsprozesses — und treiben organische PCB-Substrate an ihre fundamentalen physikalischen Grenzen.Bei diesen Datenraten ist das PCB kein passives Verbindungselement (Interconnect) — es trägt aktiv zur Bitfehlerrate (BER) des Speicherkanals bei. Dielektrischer Verlust (Df), Oberflächenrauigkeit des Kupfers (Rz) und Via-Stub-Resonanzen tragen jeweils zu einer messbaren Verschlechterung der Augenöffnung (Eye Opening) bei. Ein Fertigungsprozess, der bei 15 GHz eine Df-Abweichung von ±0,001 produziert — deutlich innerhalb der Standardtoleranzen —, kann die GDDR7-Augenmarge (Eye Margin) um ±15 % verschieben und damit potenziell die JEDEC-Konformitätsgrenze überschreiten.
Speicher-Routing-Techniken für Schnittstellen der nächsten Generation
- HBM3e Interposer-Integration: Über 2000 BGA-Balls im 0,55 mm-Raster — enger als bei vorherigen HBM-Generationen — erfordern eine HDI-Konstruktion mit sequenzieller Lamination, gestapelten Microvias (Stacked Microvias, 0,075 mm laservorgebohrt) und 2/2 mil Trace/Space für das Escape-Routing. Via-in-Pad mit Kupferfüllung (Copper Fill) und Planarisierung ist für diese Balldichte zwingend erforderlich.
- GDDR7 PAM4 Signalintegrität: PAM4-Signalisierung bei 36 Gbps erfordert eine Einfügedämpfung (Insertion Loss) von unter 2,5 dB bei 18 GHz Nyquist — was Ultra-Low-Loss-Laminate (Dk 3,0, Df 0,0015 bei 10 GHz, wie Panasonic Megtron 7 oder Isola I-Speed) mit HVLP-Kupferfolie (Rz < 1,5 μm) und impedanzkontrollierte differentielle Paare mit Längenanpassung (Length Matching) innerhalb von ±0,5 mil pro Bytegruppe erfordert.
- Pre-Route Kanal-Simulation: Vollständige S-Parameter Kanalmodelle, die mit 3D-EM-Feldlösern (nicht mit 2D-Approximationen) aus dem vorgeschlagenen Stackup extrahiert wurden, verifizieren die Augenöffnung gegen die Anforderungen der JEDEC-Maske in den Worst-Case-Prozess-Cornern (maximales Df, maximale Kupferrauigkeit, min/max dielektrische Dicke), bevor ein Layout-Commitment erfolgt.
- Crosstalk-Management auf PAM4-Spannungsniveaus: Die drei Augenöffnungen von PAM4 weisen jeweils ein Drittel der Amplitude von NRZ auf — was die Crosstalk-Toleranz (Übersprechen) für ein äquivalentes BER um 9,5 dB enger macht als bei NRZ. Die Post-Layout-Extraktion bestätigt, dass Near-End (NEXT) und Far-End Kopplung (FEXT) zwischen benachbarten GDDR7-Kanälen unter -35 dB bleiben, was einen datenabhängigen Jitter (Data-dependent Jitter) verhindert, der die ohnehin schon schmalen PAM4-Augenmargen schließen würde.
PCIe Gen 5/Gen 6 und CXL Interconnect Signalintegrität
Beschleuniger kommunizieren mit den Host-Prozessoren über PCIe Gen 5 bei 32 GT/s, wobei Gen 6 bei 64 GT/s und CXL 3.0 sich auf Plattformen der nächsten Generation herauskristallisieren. Jede Generation halbiert das Insertion-Loss-Budget (Dämpfungsbudget) und verdoppelt die Empfindlichkeit gegenüber Impedanzdiskontinuitäten — was den PCB-Kanal zum leistungslimitierenden Element macht, welches bestimmt, ob das System den theoretischen Spitzen-Durchsatz erreicht oder auf niedrigere Link-Geschwindigkeiten zurückfällt.PCIe Gen 6 führt erstmals PAM4-Signalisierung in den PCIe-Standard ein und reduziert das Kanal-Loss-Budget auf etwa 20 dB — wovon das PCB nicht mehr als 6–8 dB beanspruchen darf, einschließlich aller Via-Übergänge (Via Transitions), Diskontinuitäten von AC-Koppelkondensatoren und Steckverbinder-Interfaces. Bei einer Nyquist-Frequenz von 32 GHz zählt jede Designentscheidung: Ein suboptimaler Via-zu-Stripline-Übergang fügt 1–2 dB hinzu, und vier solcher Übergänge in einem typischen Kanal verbrauchen die Hälfte des Leiterplatten-Loss-Budgets.
PCIe Gen 5/6 Kanal-Optimierung
- Zuweisung des Loss-Budgets (Loss Budget Allocation): Gen 5 gewährt einen gesamten Kanalverlust von ca. 28 dB, wobei der PCB-Anteil unter 8–10 dB liegt. Gen 6 zieht dies auf ca. 20 dB insgesamt an, mit PCB unter 6–8 dB — dies erfordert die Eliminierung von Via-Stubs (Back-Drilling auf <6 mil Rest-Stub), ein Ultra-Low-Loss-Dielektrikum (Df < 0,002 bei 15 GHz) und HVLP-Kupfer auf allen Signallagen.
- Engineering der Via-Übergänge (Via Transition Engineering): Jeder Lagenwechsel fügt je nach Via-Geometrie 0,5–2,0 dB bei 16–32 GHz hinzu. Rückgebohrte Through-Holes (Back-drilled), Blind/Buried Vias und optimierte Via-to-Trace Anti-Pad-Geometrien werden durch 3D-EM-Simulation einzeln modelliert und durch TDR-Messungen auf Produktionsplatinen verifiziert.
- Support für CXL Memory Expansion: CXL 2.0/3.0-Links nutzen die physikalische PCIe-Schicht, erfordern jedoch eine engere Jitter-Toleranz — CXLs Cache-Kohärenz-Protokoll toleriert Retransmission-Latenzen (Neuübertragung) weitaus weniger als das Posted-Write-Modell von PCIe. Dies macht Signalintegritäts-Margen (SI Margin) für CXL-angebundene Memory-Pooling-Architekturen kritisch.
- Konformitätsüberprüfung per Augendiagramm (Eye Diagram Compliance): First-Article-Boards durchlaufen Augen-Messungen bei 32 GT/s (Gen 5) und 64 GT/s (Gen 6) mit kalibriertem BERT und Oszilloskop — was bestätigt, dass der Produktionskanal die Compliance-Maske (Konformitätsmaske) mit dokumentierter Reserve erfüllt. Augendiagramm-Messungen werden bei Betriebstemperatur durchgeführt, nicht nur bei Raumtemperatur.
Thermische Architektur für anhaltende Volllast
Parallel Computing-Boards operieren für Stunden oder Tage mit maximaler Leistung — LLM-Trainingsläufe werden wochenlang ausgeführt, Rendering-Jobs halten die Spitzen-GPU-Auslastung über Stunden aufrecht und wissenschaftliche Simulationen laufen bis zur Konvergenz. Das thermische Design muss andauernde Volllast bei spezifizierter Umgebungstemperatur (35–45 °C Lufteinlasstemperatur im RZ) handhaben, ohne dass Throttling auftritt oder sich die Lebensdauer von Bauteilen unter den regulären 5-Jahres-Ersatzzyklus im Rechenzentrum verkürzt.Die thermische Herausforderung bei Parallel-Computing-PCBs ist nicht einfach nur die Gesamtverlustleistung — es ist die Leistungsdichte (Power Density). Ein 700W GPU-Die misst etwa 800 mm² und konzentriert über 87 W/cm² an der Die-Oberfläche. Das PCB muss diese Hitze durch das Gehäusesubstrat, über die TIM-Grenzfläche (Thermal Interface Material) und in den Kühlkörper oder die Cold Plate leiten — und jeder Spalt, Void (Leerraum) oder eine Verwölbung in diesem thermischen Pfad erzeugt einen Hot Spot, der lokales Throttling auslöst und den gesamten Rechendurchsatz (Compute Throughput) mindert.
Thermisches Design für Sustained-Load (Dauerlast)
- Architektur für Prozessor Thermal Vias: Dichte thermische Via-Arrays (0,3 mm Durchmesser, 1,0 mm Pitch) unter GPU/FPGA-Packages verbinden das Top-Side BGA-Pad-Feld mit dem Bottom-Side Copper-Pour, welches über das TIM mit den Kühlkörpern in Verbindung steht. Die Füllung der Vias (mit Kupfer oder leitfähigem Epoxid) sowie eine Oberflächen-Planarisierung auf ±10 μm gewährleisten einen konstanten Kontakt mit dem TIM über den gesamten Bereich (Footprint) des Packages.
- VRM Wärmemanagement: 16–24 Induktivitäts-Phasen, die jeweils 2–4 W dissipieren (verlustbehaftet sind), bilden verteilte Wärmequellen mit insgesamt 30–60 W VRM-Verlust. Das Component Placement Zoning hält VRM-Komponenten auf der gegenüberliegenden Platinenkante fern von temperaturempfindlichen Taktoszillatoren, Spannungsreferenzen und I²C-Sensoren und hält eine thermische Trennung von ≥15 mm ein.
- Warpage Control (Kontrolle der Verwölbung) unter thermischer Last: Board-Warpage unter 0,3 % der Diagonale durch symmetrische Kupferverteilung über alle Lagen, eine ausbalancierte Lagen-Sequenz (Lamination Sequence) und die Auswahl von CTE-abgestimmtem Prepreg/Core — dies verhindert einen TIM-Kontaktverlust, der die Wärmeleitfähigkeit am Punkt der Ablösung um das 3- bis 5-fache reduziert.
- Interne Hitzespreizung (Internal Heat Spreading): Innere Lagen mit 3–4 Unzen Kupfer leiten Wärme lateral aus den konzentrierten Die-Footprints ab und verringern so die Differenz zwischen Spitzen- und Durchschnittstemperatur in der Bestückungszone des Packages. Thermische Simulationen werden mit IR-Thermografie-Messungen auf First-Article-Boards unter andauernder Belastung verifiziert.
DFM für die Fertigung von 20–32 Lagen Beschleunigerboards
Parallel-Computing-PCBs gehören zu den komplexesten kommerziell gefertigten Boards — 20–32 Lagen, die sequenzielle HDI-Lamination mit Through-Hole Vias mischen, dicke Kupferschichten (Power Planes) neben feinstrukturierter Signalentflechtung (Fine-line Signal Routing) und extrem verlustarme Materialien, die spezielle Laminierungs-Temperaturprofile erfordern. Die Produktionsausbeute (Manufacturing Yield) hängt vollständig von der DFM-Disziplin (Design for Manufacturability) während der Entwicklungsphase ab — und von der tatsächlichen Leistungsfähigkeit des Herstellers, validiert durch statistische Prozessdaten, nicht durch Marketingversprechen.Die Fertigungskapazitäten von HILPCB reichen bis zu 64 Lagen für die anspruchsvollsten Konstruktionen, wobei produktionserprobte Prozesse für 28-32-lagige Beschleunigerplatinen einen First-Pass-Yield von >92 % erreichen. Unser DFM-Review für Parallel-Computing-Boards identifiziert die komplexen Wechselwirkungen von Fertigungsrisiken, die von standardmäßigen automatisierten Design Rule Checks (DRC) übersehen werden — die Kopplung zwischen Warpage-Kräften des Dickkupfers, Verschiebungen der Passung (Registration Drift) bei der sequenziellen Lamination, der Positionsgenauigkeit beim Back-Drilling und der Temperaturempfindlichkeit von Ultra-Low-Loss Materialien beim Laminieren.
DFM-Prozess für komplexe Beschleunigerboards
- Registrierung (Alignment) bei sequenzieller Lamination: ±1,5 mil Genauigkeit von Schicht zu Schicht (Layer-to-Layer) über sequentielle Aufbauten von 20–32 Lagen hinweg, verifiziert durch Messung von Röntgen-Ausrichtungszielen (X-Ray Alignment Targets) in jedem Laminierungszyklus — dies verhindert den Via-Pad Versatz (Misalignment) beim HBM BGA-Escape-Routing (0,55 mm Pitch), wo eine Verschiebung von 2 mil bereits einen Open Circuit (Unterbrechung) verursacht.
- Kontrolle der Back-Drill Tiefe: Via-Stubs (Stummel) werden auf <6 mil kontrolliert durch lasergestütztes Back-Drilling mit prozessintegrierter Tiefenverifikation über Querschnittsmessungen (Cross-section) an jedem 50. Panel — jedes Mil eines überschüssigen Stubs erzeugt eine Viertelwellenresonanz (Quarter-Wave Resonance), die einen tiefen Notch (Einbruch) in der Kanal-Frequenzantwort produziert.
- Kupferbalance-Analyse (Copper Balance Analysis): Die Verteilung der dicken Stromlagen (4–6 Unzen) wird mittels Finite-Elemente-Modellierung auf Biegung/Verdrehung (Bow/Twist) hin analysiert — asymmetrisches Kupfer verursacht eine Verwölbung von über 0,5 %, die sowohl die Genauigkeit der Bauteilplatzierung als auch den thermischen Schnittstellenkontakt beeinträchtigt.
- Validierung der Materialkompatibilität (Material Compatibility Validation): Mixed-Material Stackups (Ultra-Low-Loss Signal-Lagen mit Standard FR-4 Power-Lagen) werden auf Laminierungskompatibilität verifiziert — CTE-Mismatch (thermische Ausdehnung) zwischen unterschiedlichen Materialien verursacht Zwischenschichtspannungen (Inter-Layer Stress), die während Temperaturzyklen (Thermal Cycling) zu Delaminierung führen können.
- Prototyp-Validierung: First-Article-Platinen (Erstmuster) mit vollständiger elektrischer Validierung (TDR, VNA, Augendiagramme), Querschnittsanalyse (Cross-section) und thermischer Charakterisierung vor dem Freigeben der Produktionswerkzeuge (Production Tooling) — dies ist von entscheidender Bedeutung, wenn ein Respin 80.000+ USD kostet und eine Projektverzögerung von 8–10 Wochen mit sich bringt.
HILPCB Parallel Computing PCB-Fertigung
HILPCB fertigt Parallel Computing-PCBs für GPU-Beschleuniger-OEMs, FPGA-Integratoren, Unternehmen für KI-Trainingsinfrastruktur und Rechenzentrumsbetreiber in Nordamerika, Europa und dem asiatisch-pazifischen Raum.Unsere Fertigungskapazitäten für Parallel-Computing-Boards umfassen sequentielle HDI-Lamination mit bis zu 64 Lagen und einer Genauigkeit von ±1,5 mil, dicke Kupfer-Stromebenen (4-6 Unzen) mit Mehrphasen-VRM-Routing für eine Bereitstellung von 800+ A, ultra-verlustarme Dielektrika (Df < 0,002 bei 15 GHz) für PCIe Gen 5/6, CXL und GDDR7, HBM3e Interposer Support mit 0,55 mm BGA-Pitch Escape Routing bei 2/2 mil Trace/Space, Warpage Control von unter 0,3 % bei anhaltender thermischer Belastung sowie IPC-6012 Class 3 Fertigung mit vollständiger Chargenrückverfolgbarkeit und VNA-verifizierter PDN-Impedanz auf jedem Produktions-Board.
Unabhängig davon, ob Sie den GPU-Beschleuniger der nächsten Generation entwickeln oder Ihre KI-Trainingsinfrastruktur skalieren, unser Engineering-Team arbeitet Seite an Seite mit Ihrem Design-Team — von der Definition des Stackups bis zum Hochfahren der Produktion (Production Ramp) — und stellt sicher, dass die Fertigungsfähigkeit validiert ist, bevor das Layout finalisiert wird (Layout Commitment), und nicht erst beim First-Article-Testing entdeckt wird.
Parallel Computing PCB FAQ
Wie handhaben Parallel-Computing-PCBs eine Stromversorgung von 800A?
Eine Stromabgabe von über 800 Ampere erfordert massive Kupferinnenlagen (4-6 Unzen) und 16-24 phasige VRMs, die so nah wie möglich am Prozessor platziert werden. Das Stromversorgungsnetzwerk (PDN) muss mithilfe von Full-Wave 3D elektromagnetischer Simulation entwickelt werden, um die Impedanz bis 500 MHz unter 0,5 mΩ zu halten und transiente Spannungseinbrüche zu verhindern.
Warum ist die Via-Stub-Länge entscheidend für 112G PAM4 Signale?
Bei 112G PAM4 (56 GHz Nyquist-Frequenz) wirken Via-Stubs (Blindenden) als resonierende Antennen, die Signalenergie absorbieren und schwerwiegende Notches (Einbrüche) in der Frequenzantwort des Kanals verursachen. Ein Rückbohren (Back-drilling) zur Begrenzung des Rest-Stubs auf <6 mils ist zwingend erforderlich, um das enge PAM4-Augendiagramm aufrechtzuerhalten.
Was verursacht Board-Verwölbung (Warpage) bei GPU-Beschleunigerkarten?
Die Verwölbung wird in erster Linie durch asymmetrische Kupferverteilung verursacht, insbesondere durch die für hohe Ströme verwendeten dicken Kupferschichten, kombiniert mit dem extremen Hitzezyklus von 700W-Workloads. Wir begrenzen das Warpage auf <0,3 % durch perfekt ausbalancierte Stackups, symmetrische Kupferflächen (Copper Pours) und Materialien mit angepasstem CTE (Wärmeausdehnungskoeffizient).
Fordern Sie ein Engineering-Review für Ihr Beschleuniger-Board-Programm an →