
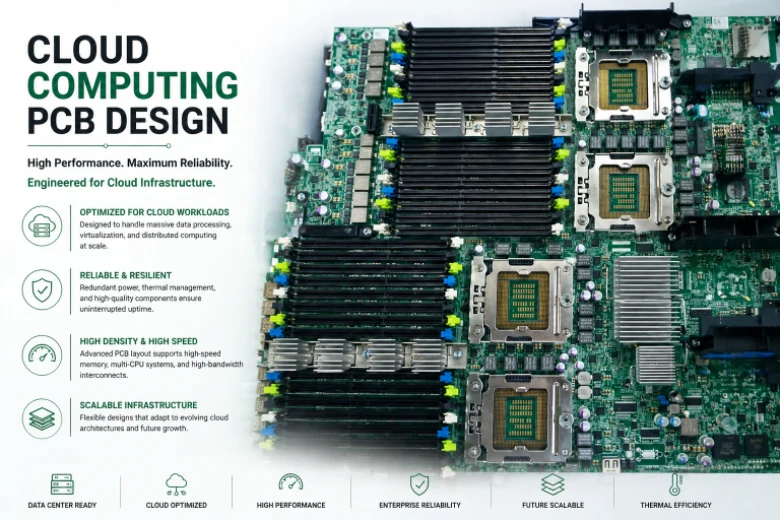
Le marché mondial des services d'infrastructure cloud a atteint 330 milliards de dollars en 2024 (Synergy Research), avec AWS, Azure, Google Cloud et les fournisseurs régionaux déployant environ 3 millions de nouveaux serveurs chaque année — chacun contenant des circuits imprimés fabriqués selon des normes de qualité hyperscale où un taux de défaillance des cartes de 0,1 % se traduit par 3 000 pannes simultanées générant des tickets d'assistance, des pénalités SLA et une logistique de remplacement à l'échelle mondiale. Le cloud computing concentre des capacités massives de traitement, de stockage et de mise en réseau dans des centres de données hyperscale — fournissant l'informatique en tant que service via un matériel dont les performances, l'efficacité énergétique et la fiabilité sont déterminées au niveau du PCB.
L'économie du matériel cloud est fondamentalement différente de celle de l'informatique d'entreprise. Un hyperscaler évaluant les cartes mères de serveurs ne demande pas « cette carte fonctionne-t-elle ? » — il calcule le coût total de possession sur des déploiements de 100 000 unités où une économie d'énergie de 2W par serveur élimine 200 kW de charge (175 000 $/an en électricité), une amélioration de la fiabilité de 0,05 % évite 50 remplacements sur site par an (25 000 $ en déplacements), et une réduction de la nomenclature (BOM) de 3 $ par carte permet d'économiser 300 000 $ par génération. Chaque décision de conception de PCB a des conséquences financières à l'échelle du parc.
HILPCB fabrique des PCB pour le cloud computing — livrant des cartes de serveurs de 16 à 28 couches à des volumes dépassant 5 000 unités par mois avec une cohérence d'impédance Cpk >1,33 — pour les équipementiers de serveurs, les fournisseurs de stockage et les entreprises de réseau construisant l'infrastructure physique du cloud computing dans le monde entier.
Navigation dans le menu
- L'économie à l'échelle du cloud au niveau de la carte
- Intégrité du signal de la carte mère du serveur : DDR5, PCIe Gen 5 et CXL
- Conception de plate-forme et de contrôleur de stockage NVMe
- Fabrication de commutateurs réseau et de cartes réseau 400G/800G
- Efficacité énergétique et conception thermique pour une densité de rack maximale
- Production en volume et continuité de l'approvisionnement
L'économie à l'échelle du cloud au niveau de la carte
Les décisions d'achat de matériel cloud sont prises grâce à une modélisation rigoureuse du TCO sur des cycles de déploiement de 3 à 5 ans. Le PCB n'est pas évalué comme un composant isolé — il est évalué comme un contributeur aux performances par watt, à la fiabilité par dollar et au coût de fabrication à grande échelle. Notre engagement de co-conception avec les équipementiers de matériel cloud optimise ces dimensions du TCO depuis la définition initiale de l'empilement (stackup) jusqu'à la montée en cadence de la production.Dimensions de l'optimisation des PCB Cloud
- Performance par Watt : Débit de calcul maximal par watt de puissance totale du système — stimulant l'optimisation de l'intégrité du signal (atteindre la pleine bande passante de l'interface sans frais de retransmission), l'ingénierie de l'efficacité du VRM (>93 % à charge typique) et la sélection de matériaux à faibles pertes qui réduisent l'échauffement diélectrique du PCB.
- Fiabilité à l'échelle du parc : MTBF continu de 5 ans ciblant un taux de défaillance annuel des cartes <0,1 % sur des parcs de 100 000 unités — atteint grâce au déclassement des composants (30 % de tension, 20 % de température sur les condensateurs électrolytiques), à la qualification des joints de soudure (+ de 2 500 cycles thermiques selon IPC-9701) et à la vérification des matériaux entrants pour prévenir les défauts latents.
- Coût de fabrication en volume : Optimisation des coûts de la nomenclature via des valeurs de composants passifs standardisées (réduisant les références uniques de 30 à 40 %), maximisation de l'utilisation des panneaux (15 à 20 % d'économie de matériaux grâce à une disposition optimisée en réseau) et conception orientée DFM qui atteint un rendement SMT au premier passage >95 %.
- Maintenabilité et gestion à distance : Capacité de remplacement à chaud pour les unités remplaçables sur le terrain, réseaux de capteurs BMC complets avec l'API Redfish et indicateurs LED de diagnostic — réduisant le temps moyen de réparation de quelques heures à quelques minutes et permettant un fonctionnement de centre de données sans tête (headless).
Intégrité du signal de la carte mère du serveur : DDR5, PCIe Gen 5 et CXL
Les cartes mères de serveurs cloud transportent simultanément les interfaces commerciales les plus rapides : DDR5 à 4800–6400 MT/s sur 8 à 12 canaux, PCIe Gen 5 à 32 GT/s sur plus de 128 voies, CXL 2.0 pour l'expansion et la mise en commun de la mémoire, et UPI/GMI pour l'interconnexion multi-sockets à 16–24 GT/s. Chaque interface a des budgets de perte laissant une marge minimale pour la contribution du PCB — et elles partagent toutes la même construction de carte de 16 à 28 couches, se faisant concurrence pour les couches de routage optimales et les ressources de plan de référence.Ingénierie de l'intégrité du signal des serveurs
- Routage DDR5 à 5600+ MT/s : Impédance asymétrique de 40Ω avec une adaptation des voies d'octets à ±1 mil et une topologie fly-by simulée pour la marge temporelle de nivellement d'écriture à chaque configuration de DIMM prise en charge (1DPC et 2DPC). Le régulateur de tension intégré au DIMM de la DDR5 nécessite un routage d'alimentation supplémentaire absent des conceptions DDR4 — rails d'alimentation VR12.5 acheminés le long des bus de données mémoire avec une isolation appropriée.
- Interconnexion Multi-Socket à 24 GT/s : Liaisons UPI 2.0 (Intel) et GMI3/Infinity Fabric (AMD) traversant 6 à 12 pouces entre les sockets du processeur avec une perte d'insertion inférieure à 8 dB à 12 GHz — nécessitant des stratifiés à faibles pertes (Df < 0,004 à 10 GHz) et des vias à perçage arrière avec un tronçon (stub) <8 mil sur des constructions de 16 à 28 couches.
- Expansion de mémoire CXL 2.0 : Interfaces d'extenseur de mémoire CXL Type 3 partageant la couche physique PCIe Gen 5 — acheminées avec des emplacements PCIe standard mais nécessitant une allocation de budget de gigue plus stricte, car le protocole de cohérence de cache du CXL est moins tolérant à la latence de retransmission au niveau de la liaison que les écritures postées PCIe.
- Vérification de l'impédance en production : Mesure de l'impédance TDR sur les coupons de test de chaque panneau de production, avec une conformité du diagramme de l'œil vérifiée sur les premiers articles aux débits de données DDR5 (5600 MT/s) et PCIe Gen 5 (32 GT/s) à l'aide d'instruments BERT étalonnés.
Conception de plate-forme et de contrôleur de stockage NVMe
L'infrastructure de stockage cloud est construite sur des SSD NVMe agrégés derrière des circuits intégrés de commutation PCIe — le PCB du contrôleur de stockage achemine de 16 à 96 voies PCIe Gen 4/5 de l'ASIC du commutateur vers les connecteurs de disques SFF-8639, E1.S ou E3.S, chaque voie nécessitant un contrôle d'impédance individuel et une vérification des pertes. Ces cartes sont simultanément des conceptions numériques à grande vitesse (PCIe à 32 GT/s) et des défis de gestion de l'alimentation (circuits intégrés de commutation dissipant 30 à 100W dans des facteurs de forme contraints).Conception de la carte du contrôleur de stockage
- Routage de distribution PCIe (Fan-Out) : Distribution du commutateur PCIe Gen 5 sur des distances de 100 à 300 mm sur des constructions multicouches (14 à 20 couches) avec des couches de signal en stratifié à faibles pertes, des transitions de vias à perçage arrière et une géométrie de lancement du connecteur optimisée — maintenant la perte de canal dans les spécifications sur les 16 à 96 voies simultanément.
- Coexistence de protocoles mixtes : Couches de routage dédiées pour le PCIe (différentiel 85Ω) et le SAS hérité (différentiel 100Ω) avec un blindage continu du plan de masse entre les protocoles — évitant la diaphonie entre les signaux PCIe 32 GT/s et SAS 22,5 Gbps qui provoquerait des erreurs de bits dans le chemin des données de stockage.
- Gestion thermique du contrôleur : Circuits intégrés de commutation de stockage dissipant 50 à 100W dans des formats de cartes HHHL ou FHFL avec des réseaux de vias thermiques, des plans d'alimentation en cuivre épais (2 à 3 oz), et un placement des composants optimisé pour un flux d'air contraint — maintenant la température de jonction en dessous du seuil d'étranglement avec une marge de 10 °C sous des charges de travail d'écriture aléatoire soutenues.
- Vérification de l'œil par voie : Conformité du diagramme de l'œil mesurée sur chaque voie PCIe lors de l'inspection du premier article — car une seule voie avec une marge d'œil marginale crée un réentraînement intermittent de la liaison qui dégrade les IOPS de stockage et la latence finale, la défaillance apparaissant comme un problème de performances de stockage plutôt que comme un défaut du PCB.
Fabrication de commutateurs réseau et de cartes réseau 400G/800G
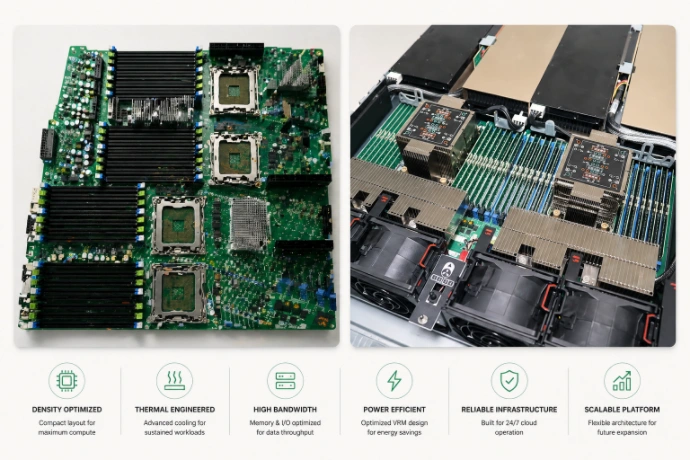
Les centres de données cloud connectent les serveurs via des cartes réseau 25G/100G/400G et des commutateurs haut de rack traitant des millions de paquets par seconde. Les commutateurs 800G de nouvelle génération utilisent le SerDes PAM4 112G (8×112G par port) avec l'émergence du PAM4 224G — créant des cartes qui sont simultanément des défis de conception numérique à ultra-haute vitesse et analogique de qualité RF. Les PCB de carte réseau (NIC) transportent des circuits intégrés PHY réseau avec 32 à 64 voies SerDes, une interface hôte PCIe Gen 5, des réseaux de connecteurs QSFP-DD/OSFP et une distribution d'alimentation sophistiquée — le tout sur des cartes mesurant 150×200 mm.Capacités de fabrication de cartes réseau
- Conception de canaux 400G/800G : 8×50G PAM4 (400G) ou 8×112G PAM4 (800G) par port avec une perte d'insertion inférieure à 5 dB à 26,5 GHz (400G) ou inférieure à 4 dB à 56 GHz (800G) — stratifiés haute fréquence (Dk 3.0, Df < 0,002 à 28 GHz) sur les couches de signaux combinés avec du FR-4 standard sur les couches d'alimentation/masse pour la gestion des coûts en production de masse.
- Échappement (Escape) de l'ASIC BGA de commutateur : Plus de 5 000 à 7 000 pastilles BGA avec des centaines de voies SerDes 112G nécessitant un PCB HDI avec un laminage séquentiel sur des constructions de 24 à 36 couches (capacité jusqu'à 64 couches). Microvias percés au laser de 0,075 mm avec des structures de vias empilés pour un échappement complet de l'ASIC dans l'ombre du boîtier — chaque voie SerDes étant réglée individuellement en impédance via l'optimisation des pastilles anti-vias (anti-pad).
- Alimentation de la carte réseau pour le traitement à la vitesse de ligne : Circuits intégrés PHY réseau tirant 25 à 50W des alimentations de base de 0,75 à 1,0V avec une régulation multiphasée maintenant la tension à ±2 % dans le pire des cas de traitement de paquets à la vitesse de ligne avec un cryptage complet — réponse transitoire VRM conçue pour les modèles de trafic en rafale caractéristiques de la communication est-ouest du centre de données.
- Pré-conformité EMI : Évaluation EMI intégrée à la disposition à l'aide de numérisation en champ proche — optimisation du rayonnement de l'antenne à fente dû aux espaces entre les plans, de la mise à la terre du blindage du connecteur et du confinement des harmoniques d'horloge pendant la conception de la carte, plutôt que de découvrir des problèmes de conformité lors des tests de certification FCC/CE/VCCI.
Efficacité énergétique et conception thermique pour une densité de rack maximale
Les centres de données cloud sont fondamentalement limités par l'énergie — chaque watt consommé par les pertes du PCB (inefficacité du VRM, perte de cuivre résistive, échauffement diélectrique) réduit la capacité de calcul disponible. À l'échelle du parc, les améliorations de l'efficacité énergétique du PCB se multiplient : une amélioration de 2W par serveur sur 100 000 serveurs élimine 200 kW de charge informatique et 60 à 100 kW de charge de refroidissement proportionnelle, permettant d'économiser plus de 225 000 $ par an.Efficacité et optimisation thermique
- Profilage de l'efficacité du VRM : Circuits intégrés de conversion sélectionnés et caractérisés en fonction du profil de charge spécifique (et pas seulement du rendement maximal) — ciblant >93 % à une charge typique de 50-70 %, >88 % à une charge d'inactivité de 10 % et >90 % à une charge soutenue de 100 %. Fréquence de commutation, sélection de l'inductance et force d'entraînement de la grille (gate) optimisées pour une efficacité pondérée en fonction de la charge sur le profil de fonctionnement réel du serveur.
- Ingénierie de la chute de tension (IR Drop) : Les rails 3,3V et 5V transportant 10 à 30A sur 6 à 10 pouces nécessitent un poids de cuivre calculé par rail et vérifié par simulation de chute de tension CC — spécifiant souvent du cuivre sélectif de 2 à 3 oz sur les couches d'alimentation à fort courant dans une construction de carte standard de 1 oz pour minimiser les pertes résistives sans augmenter le coût de fabrication sur toutes les couches.
- Disposition optimisée pour le flux d'air 1U : Placement des composants créant des canaux de flux d'air dégagés de l'admission avant à l'échappement arrière dans des serveurs 1U avec un dégagement en hauteur total de 40 à 44 mm. Les composants de grande taille (inductances VRM, condensateurs électrolytiques) sont placés en aval où ils bénéficient d'un flux d'air pré-refroidi en amont plutôt que de créer des blocages pour les composants en aval.
- Déclassement thermique pour les conditions de centre de données : Sélection de composants avec déclassement de température assurant un fonctionnement fiable à une entrée d'air de 35 °C (classe ASHRAE A1) et 45 °C (ASHRAE A3/A4 pour les centres de données à refroidissement gratuit, « free-cooling ») — l'adoption croissante du refroidissement gratuit dans les centres de données cloud augmente les températures ambiantes au-delà de ce que prévoient les conceptions de serveurs existantes.
Production en volume et continuité de l'approvisionnement
La production de matériel cloud suit des modèles distincts : des cycles de conception de 6 à 12 mois motivés par les nouvelles générations de processeurs, des montées en puissance de production rapides, du projet pilote à des milliers par mois en 8 à 12 semaines, des constructions soutenues à volume maximal pendant 18 à 24 mois, et une fin de vie gérée avec des fenêtres de dernier achat de 12 mois. L'agilité de fabrication et la continuité de l'approvisionnement déterminent si un OEM respecte les calendriers de construction de son centre de données — un retard de 4 semaines dans la livraison des serveurs peut repousser d'un trimestre complet le déploiement d'un centre de données de 50 millions de dollars.Cadre de production et de chaîne d'approvisionnement
- Prototypage rapide : Cartes de développement initiales en 5 à 7 jours ouvrables pour l'allumage du matériel (bring-up), le développement du BIOS et la validation du micrologiciel — permettant aux équipes matérielles de commencer l'intégration du système pendant la finalisation de l'outillage de production.
- Qualification de la production pilote : Séries de 100 à 500 cartes établissant les paramètres de processus de fabrication, les lignes de base de rendement et les mesures de couverture des tests — cartes pilotes utilisées pour la qualification du système, la certification réglementaire et l'échantillonnage client.
- Montée en puissance des volumes jusqu'à 5 000+/mois : Assemblage SMT automatisé avec test in situ (ICT), balayage des limites (Boundary Scan/JTAG) et vérification fonctionnelle — ligne de production qualifiée pour une qualité constante au volume maximum avec un suivi SPC en temps réel sur les processus critiques.
- Planification de la continuité de l'approvisionnement : Stock tampon pour les composants dont le délai de livraison est > 6 semaines, deuxièmes sources qualifiées pour tous les circuits intégrés à source unique, et gestion proactive des fins de vie (EOL) avec un préavis de 18 mois — protégeant les programmes de production pluriannuels contre les perturbations de l'approvisionnement en composants.
FAQ sur les PCB du cloud computing
Quels sont les principaux défis en matière d'intégrité du signal dans les cartes mères de serveurs cloud ?
Les cartes mères de serveurs cloud doivent acheminer simultanément des interfaces haut débit telles que la DDR5 (5600+ MT/s), le PCIe Gen 5 (32 GT/s) et le CXL 2.0. Cela nécessite un contrôle strict de l'impédance, des matériaux stratifiés à faibles pertes et des structures de vias avancées (comme le perçage arrière) pour minimiser les pertes d'insertion et préserver l'intégrité du signal sur des constructions de cartes de 16 à 28 couches.
Quel est l'impact de la conception des PCB sur l'efficacité énergétique des centres de données ?
L'efficacité énergétique des PCB est directement proportionnelle à des milliers de serveurs. Concevoir pour une chute de tension (IR Drop) minimale en utilisant des plans d'alimentation en cuivre épais et en optimisant l'efficacité du module de régulateur de tension (VRM) peut économiser des watts par serveur, ce qui se traduit par des centaines de kilowatts d'économies sur un déploiement de centre de données hyperscale.
Pourquoi la gestion thermique est-elle critique pour les contrôleurs de stockage NVMe ?
Les circuits intégrés de commutation PCIe NVMe peuvent dissiper de 50 à 100W dans des facteurs de forme restreints. Des réseaux de vias thermiques efficaces, des plans en cuivre épais pour la propagation latérale de la chaleur et un placement optimisé des composants sont nécessaires pour maintenir les températures de jonction en dessous des seuils d'étranglement (throttling) et garantir des IOPS de stockage soutenus.
Planifiez un examen de co-conception de matériel cloud avec notre équipe d'ingénierie →