
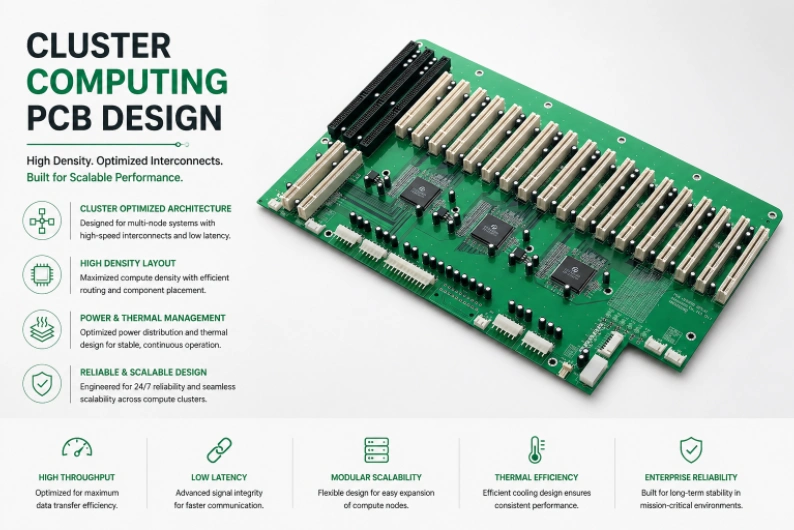
Le marché mondial des clusters HPC a dépassé les 49 milliards de dollars en 2024, la formation en IA d'entreprise et la simulation scientifique stimulant la demande pour une intégration de nœuds plus étroite, une bande passante d'interconnexion plus rapide et des configurations denses en GPU qui poussent la conception des PCB de serveurs lames à ses limites. Le calcul en cluster (cluster computing) connecte des nœuds colocalisés via des interconnexions à bande passante élevée et à faible latence — permettant des charges de travail parallèles étroitement couplées où les nœuds échangent des données chaque milliseconde lors des synchronisations de barrières MPI, des opérations all-reduce et des échanges avec les voisins dans les calculs de type stencil.
La distinction critique entre le calcul en cluster et les systèmes distribués à couplage lâche est l'intensité des communications. Une simulation CFD exécutée sur 512 nœuds de cluster effectue des opérations MPI_Allreduce impliquant chaque nœud des milliers de fois par seconde — chaque synchronisation attendant que le nœud le plus lent se termine. Une tâche de formation à l'IA effectuant un moyennage de gradient en parallèle des données sur 256 nœuds GPU exécute des opérations all-reduce après chaque mini-lot, la latence du réseau s'ajoutant directement au temps d'itération de la formation. Cette intensité de communication signifie que le chemin d'interconnexion — et le PCB qui le porte — détermine si l'ajout de nœuds améliore les performances ou crée une surcharge.
HILPCB fabrique des PCB pour le calcul en cluster, notamment des cartes au format lame de 500 mm avec une tolérance de planéité de 0,2 %, des cartes adaptateurs InfiniBand HDR/NDR et des assemblages de fond de panier/midplane — pour les intégrateurs de systèmes construisant des clusters de formation HPC et d'IA en Amérique du Nord, en Europe et en Asie-Pacifique.
Navigation dans le menu
- Architecture de nœuds axée sur l'interconnexion
- InfiniBand HDR/NDR et routage Ethernet haute vitesse
- Facteur de forme de la lame : Routage dans un couloir de 30×500 mm
- Distribution de puissance de plusieurs kilowatts pour les lames denses en GPU
- Fiabilité pour le fonctionnement du cluster non-stop
- Fabrication intégrée de lames et de midplanes
Architecture de nœuds axée sur l'interconnexion
Les nœuds de cluster modernes sont construits autour de processeurs de classe serveur ou d'accélérateurs GPU, pris en charge par 8 à 12 canaux DDR5, une extension PCIe Gen 5 et une interconnexion InfiniBand ou Ethernet 200G/400G. La philosophie de conception critique différenciant les cartes de cluster des cartes de serveurs générales est la priorité à l'interconnexion — l'interface réseau reçoit le chemin PCIe le plus court, les meilleures couches de routage pour l'intégrité du signal et la position thermique la plus favorable avant tout autre sous-système.Dans un serveur standard, l'interface réseau est l'un des nombreux périphériques en concurrence pour les voies PCIe et les ressources de routage de la carte. Dans un nœud de cluster conçu pour la communication MPI, l'interface réseau fonctionne en permanence à la vitesse de la ligne — l'InfiniBand NDR 400G maintient une bande passante bidirectionnelle de 50 Go/s sans les périodes d'inactivité que connaissent les serveurs cloud entre des requêtes indépendantes. Ce profil d'utilisation soutenu signifie que toute déficience de l'intégrité du signal sur le chemin réseau limite directement le débit de calcul global du cluster.
Priorités de conception spécifiques au cluster
- Allocation PCIe axée sur l'interconnexion : Réseau HCA (Host Channel Adapter) ou SmartNIC placé sur les voies PCIe Gen 5 x16 acheminées directement à partir du complexe racine (root complex) du CPU — le chemin PCIe le plus court, à perte la plus faible et à latence la plus faible de la carte. Le stockage et les périphériques reçoivent les voies PCIe restantes via un commutateur ou des ports en aval.
- DDR5 multicanal pour les MPI à forte intensité de données : 8 à 12 canaux DDR5 acheminés avec une adaptation de voie d'octet (byte-lane) à ±1 mil sur les couches de PCB haute vitesse — prenant en charge la bande passante mémoire maximale pour les opérations de tampon MPI où les performances de conditionnement/déconditionnement des messages sont limitées par la bande passante mémoire.
- Intégration d'accélérateurs GPU : Emplacements PCIe Gen 5 x16 pour 4 à 8 accélérateurs GPU avec une alimentation prenant en charge plus de 500W par carte via une distribution en cuivre épais à partir de l'alimentation 48V du fond de panier — les nœuds de cluster équipés de GPU dissipent 2 000 à 4 000W au total, nécessitant une infrastructure de distribution d'énergie qui dépasse la conception standard des serveurs.
- Interface du connecteur Midplane : Empreintes de connecteur en bord de carte correspondant précisément aux spécifications du midplane du châssis, l'impédance étant maintenue en continuité tout au long de la transition carte-connecteur — vérifiée par la mesure du paramètre S de l'interface de couplage lors de la qualification du premier article.
InfiniBand HDR/NDR et routage Ethernet haute vitesse
La latence de communication MPI détermine directement l'efficacité de la mise à l'échelle de l'application de cluster. Le chemin du réseau PCB — du complexe racine PCIe du processeur via les traces de la carte, les transitions de vias et le connecteur jusqu'au réseau HCA SerDes — contribue directement à la latence de chaque opération MPI et détermine la bande passante maximale réalisable de la matrice (fabric).L'InfiniBand NDR à 400G par port utilise 4 voies de signalisation PAM4 100G — chaque voie fonctionnant au même débit de données qui nécessitait des matériaux à ultra-faibles pertes et une fabrication de précision il y a seulement 3 ans pour les cartes de commutation les plus exigeantes. Cette exigence d'intégrité du signal s'applique désormais à chaque carte de nœud de cluster du système.
Intégrité du signal d'interconnexion
- Routage InfiniBand NDR 400G : 4 voies × 100G PAM4 par port avec une perte d'insertion inférieure à 4,5 dB à 26,5 GHz Nyquist — obtenue grâce à des stratifiés à faibles pertes (Df < 0,003 à 15 GHz), une feuille de cuivre HVLP (Rz < 2,0 μm) et l'élimination du tronçon (stub) de via par perçage arrière (back-drilling) ou construction de via borgne sur toutes les transitions de couches.
- Optimisation du chemin RDMA GPU-Direct : Routage PCIe direct du slot GPU à la carte réseau (NIC) avec un nombre de sauts minimal (zéro traversée de commutateur PCIe) et une impédance cohérente dans toutes les transitions — permettant une communication GPU à GPU entre les nœuds au débit de ligne 400G sans implication du CPU, ce qui est critique pour les opérations collectives NCCL/RCCL dans la formation à l'IA distribuée.
- Latence déterministe à travers le chemin matériel : Les discontinuités d'impédance et les résonances du tronçon de via créent des interférences inter-symboles qui se manifestent par des variations de latence dépendantes des données — augmentant la latence finale au 99e centile qui devient le goulot d'étranglement pour les synchronisations de barrières MPI où la communication la plus lente détermine le temps d'attente à l'échelle du système.
- Vérification du diagramme de l'œil en production : Qualité du canal vérifiée par la mesure du diagramme de l'œil à des débits de données PAM4 de 100G sur les cartes du premier article — et pas seulement par la mesure d'impédance statique TDR, qui manque les mécanismes de perte dépendant de la fréquence qui dominent aux débits de données PAM4.
Facteur de forme de la lame : Routage dans un couloir de 30×500 mm
Les serveurs lames maximisent la densité de calcul — un châssis 10U accueillant 16 à 20 lames, contenant chacune un nœud de calcul complet sur un PCB contraint à une largeur d'environ 30 mm et à une longueur allant jusqu'à 500 mm. Ce rapport d'aspect extrême (16:1 ou plus) crée des défis de routage et thermiques fondamentalement différents de la conception standard de carte mère de serveur.Défis de conception de PCB spécifiques aux lames
- Routage des signaux dominé par la longueur : Tous les signaux à grande vitesse traversent toute la longueur de la carte de 400 à 500 mm — les bus de commande/adresse DDR5 s'étendent sur 100 à 150 mm, les voies PCIe x16 courent sur plus de 200 mm jusqu'au connecteur de fond de panier, et le routage des rails d'alimentation couvre l'ensemble de la carte. Ces longueurs consomment agressivement le budget de perte d'insertion — un FR-4 standard avec Df de 0,020 à 10 GHz crée une perte de plus de 6 dB sur les routes DDR5 qui dépasse la marge de synchronisation, forçant la sélection de matériaux à faibles pertes même pour les interfaces qui fonctionnent sur du FR-4 standard dans des formats de carte plus larges.
- Intégration mécanique du connecteur de fond de panier : Empreintes de connecteur côté lame fixées par la spécification du châssis (généralement PICMG 3.0 ou propriétaire) — la disposition du PCB doit atteindre les positions exactes des broches à ±2 mil tout en maintenant l'impédance de la paire différentielle à travers la zone de transition carte-connecteur sur des constructions multicouches de 16 à 24 couches.
- Extraction thermique confinée : L'espacement des lames de 30 mm limite la hauteur du dissipateur thermique à 15-20 mm avec un flux d'air transversal minimal. L'extraction de chaleur repose sur des interfaces thermiques en bord de carte (ponts thermiques en cuivre conduisant aux rails froids du châssis) et des plages de contact sur la face inférieure — des plans internes en cuivre épais (2 à 3 oz) fournissent la propagation thermique latérale essentielle des empreintes concentrées des puces vers les ponts thermiques montés sur les bords.
- Contrôle du gauchissement avec un rapport d'aspect extrême : Les cartes lames longues et minces sont intrinsèquement sujettes au gauchissement — le rapport longueur/largeur amplifie toute asymétrie de distribution de cuivre. Une distribution symétrique du cuivre sur toutes les couches et une séquence de laminage équilibrée maintiennent la planéité à ±0,2 % de la diagonale — critique pour l'accouplement fiable du connecteur de fond de panier et le contact constant de l'interface thermique.
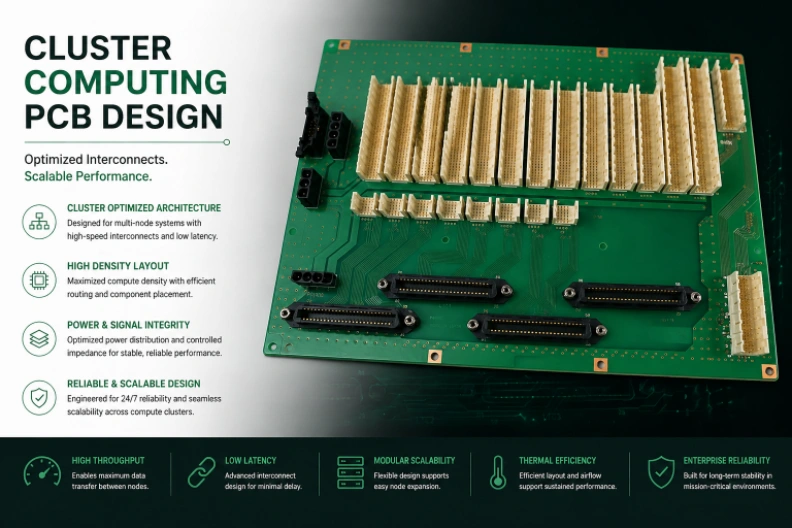
Distribution de puissance de plusieurs kilowatts pour les lames denses en GPU
Les lames de cluster équipées de GPU représentent la densité de puissance la plus élevée dans n'importe quel facteur de forme informatique — une lame avec 2 processeurs et 4 accélérateurs GPU tire de 2 500 à 4 000W de l'alimentation 48V du fond de panier, le tout converti en plusieurs rails de tension inférieurs à 1V dans l'empreinte du PCB de la lame. Un châssis 10U avec 16 de ces lames concentre de 40 à 64 kW dans moins d'un demi-rack — une densité de puissance dépassant la plupart de l'électronique commerciale d'un ordre de grandeur.Architecture d'alimentation de la lame
- Conversion directe 48V vers la charge : Architecture en deux étapes (bus intermédiaire 48V→6V + buck multiphase 6V→Vcore) réduisant les pertes de distribution de 4 à 6 fois par rapport à un bus 12V. Routage 48V sur des couches d'alimentation dédiées avec une ligne de fuite appropriée (>0,5 mm pour l'isolation fonctionnelle selon la norme CEI 62368-1) et gestion des transitoires de commutation pour les convertisseurs demi-pont 48V commutant à 300-500 kHz.
- Partage de courant actif entre les entrées redondantes : Alimentations 48V redondantes du midplane avec un équilibrage de courant actif — maintenant la continuité de l'alimentation sans faille pendant les défaillances du module d'alimentation N+1 sans les transitoires de tension qui réinitialiseraient les processeurs ou corrompraient le calcul en vol.
- Compensation de la chute de tension sous les transitoires GPU : Le lancement du noyau GPU crée des transitoires de courant de 200 à 300 A/μs du repos à la pleine charge — l'impédance de la ligne de charge est calibrée pour compenser la chute de tension (IR Drop) du PCB, maintenant la régulation de tension sur le pad du die du processeur à ±5 mV tout au long de l'événement transitoire.
- Télémétrie d'alimentation par rail : Détection de courant basée sur un shunt (précision de ±1 %) et surveillance de la tension sur chaque rail principal — fournissant des données au BMC pour la gestion de l'alimentation au niveau du rack, l'application de la politique thermique et la maintenance prédictive par la détection d'anomalies sur les modèles de consommation d'énergie.
Fiabilité pour le fonctionnement du cluster non-stop
Les nœuds de cluster fonctionnent en continu pendant des années. La maintenance non planifiée sur un seul nœud oblige les travaux MPI en cours d'exécution à créer un point de contrôle (checkpoint), à évacuer le nœud défaillant et à redémarrer — un processus qui peut gaspiller des heures de temps de calcul sur des centaines de nœuds pour une simulation à grande échelle. Faisant de la fiabilité sur le terrain le facteur dominant du coût total de possession (TCO) pour les installations de calcul en cluster.Cadre de fiabilité du cluster
- Qualification étendue des composants : Les condensateurs électrolytiques sont déclassés de 30 % en tension et de 20 % en température au-dessus des limites nominales, les MLCC sont spécifiés au minimum comme X7R (C0G pour les circuits critiques en termes de synchronisation), et les MOSFET ont un Rdson thermique maintenant une marge de 25 % au-dessus du courant constant maximum à la température de jonction la plus défavorable.
- Assemblage SMT pour une durée de vie prolongée : Joints de soudure SAC305 qualifiés via 3 000+ cycles thermiques selon l'IPC-9701 dans la plage de température de fonctionnement réelle de la lame — 3× la qualification standard de 1 000 cycles, validée par une analyse de coupe transversale et des tests de traction/cisaillement après les cycles.
- Détection prédictive des défaillances : Les interfaces de capteurs BMC surveillent les courants de phase VRM, l'ESR des condensateurs (par mesure d'impédance), les taux d'erreur DIMM (par les compteurs ECC) et les tendances thermiques — permettant le remplacement programmé des composants dégradés avant défaillance pendant les fenêtres de maintenance planifiées.
- Architecture réparable sur le terrain : Conception de carte modulaire avec des points de test accessibles pour le diagnostic sur site à l'aide d'un multimètre et d'un oscilloscope standard — permettant aux techniciens de terrain de niveau 2 d'identifier les sous-systèmes défaillants sans renvoyer les cartes au fabricant.
Fabrication intégrée de lames et de midplanes
Les programmes de cluster suivent des séquences de construction structurées — de 5 à 10 exécutions de bring-up de cartes pour le développement du micrologiciel, de 50 à 200 cartes pilotes pour l'intégration du système et de 500 à 10 000+ constructions de production pour le déploiement chez le client. Le défi de fabrication unique du calcul en cluster est que les PCB de la lame et les PCB du fond de panier/midplane doivent être fabriqués ensemble avec un contrôle dimensionnel coordonné, car le couplage des connecteurs entre la lame et le midplane dépend de la conformité simultanée des deux cartes à leurs spécifications de tolérance respectives.Production coordonnée
- Bring-Up de prototypes : De 5 à 10 cartes de lame et sections de midplane correspondantes livrées en 5 à 7 jours ouvrables avec un approvisionnement complet en composants — permettant le développement simultané du micrologiciel de la lame et des tests d'intégration du midplane.
- Co-fabrication de midplane : Les PCB de lame et les cartes de fond de panier/midplane sont fabriqués avec une vérification coordonnée de l'alignement des connecteurs — cartes de fond de panier multicouches (jusqu'à plus de 40 couches) avec des trous de connecteur à ajustement par pression (press-fit) à une tolérance de position de ±1,5 mil, vérifiés par rapport aux empreintes de connecteur de lame correspondantes.
- Mise à l'échelle clé en main (Turnkey) : Assemblage automatisé avec ICT, test des limites (boundary scan), test fonctionnel et déverminage (burn-in) — maintien de la cohérence de lame à lame dans les lots de production s'étendant sur des mois de déploiement chez les clients.
- Vérification du connecteur au niveau du système : Mesure de la force d'insertion et vérification de la résistance de contact sur les paires de connecteurs lame-midplane — assurant une connexion électrique fiable sur les 50 000+ cycles d'insertion attendus pendant la durée de vie du système.
FAQ sur les PCB pour le calcul en cluster
Pourquoi les PCB des serveurs lames sont-ils confrontés à des défis de routage extrêmes ?
Les PCB des serveurs lames ont un rapport d'aspect extrême (par exemple, 30x500 mm), ce qui signifie que les signaux haut débit comme le PCIe x16 ou la DDR5 doivent parcourir de longues distances. Cette longueur consomme agressivement le budget de perte d'insertion, forçant l'utilisation de matériaux à très faible perte et un contrôle précis de l'impédance pour maintenir l'intégrité du signal du processeur jusqu'au connecteur du fond de panier.
Comment la distribution d'alimentation est-elle gérée sur les lames de cluster denses en GPU ?
Une lame de cluster avec plusieurs GPU peut tirer de 2 500 à 4 000W. Pour gérer cela efficacement, les cartes utilisent une architecture de conversion directe de 48V vers la charge avec des convertisseurs de bus intermédiaires, acheminée sur des couches d'alimentation en cuivre épais dédiées pour minimiser la chute de tension (IR Drop) et gérer les transitoires de courant élevés pendant les pics de charge GPU.
Pourquoi les PCB de lame et les PCB de midplane doivent-ils être co-fabriqués ?
Une connexion fiable entre une lame et un midplane repose sur un alignement précis des connecteurs. La co-fabrication des deux cartes garantit que les empreintes des connecteurs de lame et les trous press-fit du midplane respectent des tolérances dimensionnelles coordonnées, garantissant un accouplement sécurisé et la continuité électrique.
Commencez votre programme de PCB de système de cluster — demandez une évaluation de carte lame →