

Глобальный рынок GPU-вычислений достиг $52,4 млрд в 2024 году, причем рабочие нагрузки по обучению ИИ и инференсу (выводу) стимулировали рост спроса на карты-ускорители на 38% в годовом исчислении. Параллельные вычисления выполняют тысячи операций одновременно — графические процессоры обрабатывают слои нейронных сетей через 16 384 ядер CUDA, FPGA запускают пользовательские конвейеры инференса на скорости среды передачи данных (wire speed), а многокристальные (chiplet) процессоры разделяют симуляции гидродинамики на 128+ потоков. Печатная плата (PCB) для параллельных вычислений должна обеспечивать экстремальную пропускную способность памяти, превышающую 3 ТБ/с, подачу мощности в несколько сотен ватт с импедансом цепи питания (PDN) менее миллиома и целостность сигнала для интерфейсов 112G PAM4 — и всё это в рамках тепловых и механических ограничений, которые выводят производство печатных плат на абсолютный предел возможностей.
Бум обучения искусственного интеллекта сделал печатные платы для параллельных вычислений самым быстрорастущим сегментом в производстве высокопроизводительных плат. Карты-ускорители NVIDIA H100/H200 и AMD MI300X требуют 20-32-слойных конструкций с последовательным ламинированием HDI, слоями питания из толстой меди 4-6 унций (oz) и потерями в канале, достаточно жестко контролируемыми для поддержки передачи сигналов 112G PAM4. Компания HILPCB производит печатные платы для параллельных вычислений с числом слоев до 64 — включая 28-слойные платы с медью 6 унций, пропускающие 800+ А к корпусам процессоров — для OEM-производителей ускорителей GPU и FPGA, а также системных интеграторов, развертывающих инфраструктуру обучения ИИ и HPC (высокопроизводительные вычисления) в дата-центрах по всему миру.
Навигация по меню
- Почему параллельные вычисления создают экстремальные требования к печатным платам
- Архитектура доставки питания для карт-ускорителей 700 Вт+
- Трассировка интерфейса памяти HBM3e и GDDR7
- Целостность сигнала межсоединений PCIe Gen 5/Gen 6 и CXL
- Тепловая архитектура при длительной полной нагрузке
- DFM для производства 20–32-слойных плат ускорителей
- Производство печатных плат для параллельных вычислений HILPCB
Почему параллельные вычисления создают экстремальные требования к печатным платам
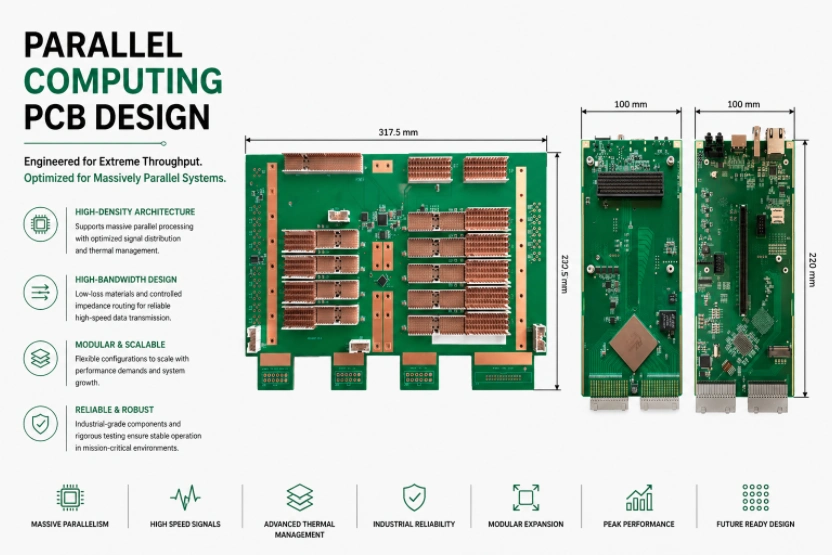
GPU-ускоритель текущего поколения концентрирует 700 Вт мощности, 3,35 ТБ/с пропускной способности памяти HBM3e и 128 линий PCIe Gen 5/CXL 2.0 на одной печатной плате размером примерно 267×112 мм. Эти требования суммируются во всех областях проектирования одновременно — подача питания, целостность сигнала, терморегулирование и механическая стабильность — все работают на своих абсолютных физических пределах с нулевым запасом на производственные отклонения.Техническая проблема заключается не в каком-либо отдельном параметре — проблема в их взаимодействии. Плоскости из толстой меди, необходимые для подачи питания 800 А, создают разрывы импеданса (impedance discontinuities), которые создают помехи для соседних трасс сигнала 112G PAM4. Массивы тепловых переходных отверстий (thermal via arrays), необходимые для отвода тепла, поглощают каналы трассировки, требуемые для разводки (escape) HBM3e. Зоны размещения катушек индуктивности многофазного VRM конфликтуют с запретными зонами высокоскоростной шины памяти. Разрешение этих взаимодействий требует скоординированной междисциплинарной проверки проекта, для выполнения которой у немногих производителей есть соответствующий опыт.
Программа HILPCB по печатным платам для параллельных вычислений решает эти комплексные проблемы посредством одновременного совместного проектирования системы питания, сигналов и теплоотвода — выявляя и устраняя конфликты между геометрией плоскостей питания, высокоскоростными каналами трассировки и массивами тепловых переходных отверстий до того, как они поступят в производство.
Определяющие проблемы проектирования печатных плат для параллельных вычислений
- Концентрация мощности: 800+ А при напряжении ядра менее 0,75 В с пульсациями <5 мВ при переходных процессах 200 А/мкс — требуется 16-24-фазный VRM с плоскостями из толстой меди (внутренние слои 4-6 унций), которые не должны создавать разрывов импеданса для соседней трассировки сигналов 112G.
- Пропускная способность памяти на пределах субстрата: Интерфейсы HBM3e на 9,6 Гбит/с на контакт через 1024-битные шины и GDDR7 на 36 Гбит/с на контакт с использованием сигналов PAM4 — скорости передачи данных, при которых диэлектрические потери печатной платы (Df) и шероховатость меди являются основными ограничителями пропускной способности, а не скорость кремния.
- Механическое напряжение под термической нагрузкой: Коробление платы (warpage) ниже 0,3% по диагонали при длительной термической нагрузке 700 Вт — для предотвращения потери контакта теплового интерфейса (TIM), усталости припоя BGA и отсоединения разъема PCIe во время многодневных сеансов обучения моделей.
- Сложность производства в масштабе: 20-32 слоя, смешивающие последовательное ламинирование HDI со сквозными переходными отверстиями, плоскости питания из толстой меди 4-6 унций и трассировка сигнала с зазором/шириной линии 3/3 мил на диэлектриках со сверхнизкими потерями (ultra-low-loss) — проблемы с выходом годных изделий, требующие производственного опыта, который исключает типичный для менее квалифицированных производителей уровень брака в 30-40%.
Эти требования делают печатные платы для параллельных вычислений одними из самых технически сложных в производстве коммерческих плат — и самыми дорогостоящими, если качество изготовления не соответствует требованиям.
Архитектура доставки питания для карт-ускорителей 700 Вт+
Параллельное оборудование потребляет мощность, сопоставимую с промышленным оборудованием — графический процессор для обучения моделей (LLM) непрерывно потребляет 700 Вт в течение нескольких дней, массив FPGA бесконечно поддерживает потребление 400 Вт во время транскодирования видео в реальном времени, а ускорители следующего поколения, согласно дорожной карте, превысят 1000 Вт на карту. Чистое электропитание на этих уровнях определяет, достигает ли ускоритель заявленной пропускной способности TFLOPS или снижает производительность из-за падения напряжения (voltage droop), вызванного переходными процессами, что может снизить производительность обучения на 15–20%.Задача проектирования сети распределения питания (PDN) фундаментально отличается от стандартных серверных плат. Кристалл GPU, выполняющий умножение матриц на всех 16 384 ядрах, создает скачки тока свыше 200 А/мкс — настолько быстрые, что даже на хорошо спроектированных плоскостях питания возникает падение напряжения, если профиль импеданса PDN не является плоским в диапазоне от постоянного тока (DC) до 500 МГц. Это требует не только толстой меди, но и точно спроектированной геометрии плоскостей с размещением развязывающих конденсаторов (decoupling), подтвержденным электромагнитным 3D-моделированием (full-wave).
Инженерия PDN для параллельных ускорителей
- Многофазная топология VRM: 16-24-фазные понижающие преобразователи (buck converters) с силовыми каскадами DrMOS и катушками индуктивности, расположенными в пределах 2 мм от шариков питания микросхемы. Петли фазного тока трассированы на слоях из толстой меди (4-6 унций на внутренних, 6-10 унций на внешних слоях на выделенных силовых модулях), сохраняя индуктивность петли (loop inductance) ниже 80 пГн на фазу.
- Секционирование плоскостей питания на выделенных слоях: Раздельные, непрерывные медные плоскости для напряжения ядра (0,65-0,85 В), HBM I/O (1,05 В), SerDes (0,9 В) и вспомогательных шин — каждая на выделенных многослойных плоскостях без пересечения сигнальными переходными отверстиями. Геометрия антипадов вокруг сигнальных переходных отверстий оптимизирована с помощью 3D-решателя поля (3D field solver) для предотвращения локальных скачков импеданса в плоскостях питания.
- Распределенная развязка по целевому импедансу: 400–800 конденсаторов, размещенных на основе полного 3D-моделирования импеданса PDN — а не эмпирического размещения — для поддержания импеданса PDN ниже 0,5 мОм в диапазоне от постоянного тока (DC) до 500 МГц. Соединения переходных отверстий от площадок конденсаторов к плоскостям питания/земли используют переходные отверстия в площадке (via-in-pad) с обратным высверливанием (back-drilled stubs) для минимизации эквивалентной последовательной индуктивности (ESL).
- Телеметрия тока в реальном времени: Сети высокоточных шунтирующих резисторов (допуск ±0,5%, 4-проводная схема Кельвина) на каждой основной шине, обеспечивающие измерение мощности в реальном времени с точностью ±1% — интегрированные с управлением инфраструктурой ЦОД через PMBus/I²C для ограничения мощности GPU и координации теплового троттлинга.
Утвержденный процесс контроля целостности питания
Каждая плата ускорителя проходит измерение импеданса PDN с использованием векторного анализатора цепей (VNA) в диапазоне от 100 Гц до 1 ГГц, подтверждая, что изготовленная плата соответствует смоделированному профилю целевого импеданса во всех диапазонах частот (декадах). Платы, не проходящие проверку по маске импеданса, отбраковываются до монтажа компонентов, предотвращая дорогостоящее обнаружение проблем с целостностью питания на этапе системной интеграции.
Трассировка интерфейса памяти HBM3e и GDDR7
Параллельные процессоры достигают своей пропускной способности за счет доступа к памяти по чрезвычайно широким и быстрым шинам. HBM3e использует 1024-битные интерфейсы на скорости 9,6 Гбит/с на контакт, обеспечивая 1,2 ТБ/с на стек (4,8 ТБ/с на четыре стека); GDDR7 использует 256-битные шины на скорости 36 Гбит/с на контакт с применением сигнала PAM4. Эти интерфейсы памяти нового поколения определяют количество слоев платы, систему материалов и сложность производственного процесса — и выводят органические подложки печатных плат (organic PCB substrates) на их фундаментальные физические пределы.При таких скоростях передачи данных печатная плата не является пассивным соединением — она активно влияет на частоту битовых ошибок (BER) канала памяти. Диэлектрические потери (Df), шероховатость поверхности меди (Rz) и резонанс отростков переходных отверстий (via stub resonance) — каждое из этих явлений вносит измеримое ухудшение в раскрытие глаз-диаграммы (eye opening). Производственный процесс, допускающий отклонение Df на ±0,001 при 15 ГГц — что в пределах стандартных допусков — может сместить запас для глаз-диаграммы GDDR7 на ±15%, потенциально выйдя за пределы соответствия стандарту JEDEC.
Методы трассировки памяти для интерфейсов нового поколения
- Интеграция интерпозера HBM3e: Более 2000 шариков BGA с шагом 0,55 мм — плотнее, чем у предыдущих поколений HBM — что требует применения конструкции HDI с последовательным прессованием, многоярусными микропереходными отверстиями (stacked microvias, диаметром 0,075 мм, высверленными лазером) и шириной линии / зазором 2/2 мил для вывода трасс (escape routing). Технология размещения переходного отверстия в контактной площадке (via-in-pad) с медным заполнением и планаризацией является обязательной для такой плотности выводов.
- Целостность сигнала GDDR7 PAM4: Сигнал PAM4 на скорости 36 Гбит/с требует, чтобы вносимые потери были ниже 2,5 дБ на частоте Найквиста 18 ГГц — для этого необходимы ламинаты со сверхнизкими потерями (Dk 3,0, Df 0,0015 при 10 ГГц, такие как Panasonic Megtron 7 или Isola I-Speed) с медной фольгой HVLP (Rz < 1,5 мкм) и дифференциальные пары с контролируемым импедансом, с выровненной длиной в пределах ±0,5 мил по каждой байтовой группе.
- Моделирование канала перед трассировкой: Полные модели канала по S-параметрам, извлеченные из предполагаемой структуры слоев (stackup) с помощью 3D-электромагнитных решателей (а не 2D-аппроксимаций), проверяют раскрытие "глаза" на соответствие требованиям маски JEDEC в наихудших технологических углах (максимальный Df, максимальная шероховатость меди, мин/макс толщина диэлектрика) до утверждения топологии.
- Управление перекрестными помехами на уровнях напряжения PAM4: Три "глаза" сигнала PAM4 имеют амплитуду в три раза меньше, чем у NRZ — что делает допуск по перекрестным помехам на 9,5 дБ более жестким, чем у NRZ при эквивалентном BER. Экстракция после трассировки (post-layout) подтверждает, что переходное затухание на ближнем (NEXT) и дальнем (FEXT) концах между соседними каналами GDDR7 остается ниже -35 дБ, предотвращая джиттер, зависящий от данных (data-dependent jitter), который может сузить и без того узкие запасы "глаза" PAM4.
Целостность сигнала межсоединений PCIe Gen 5/Gen 6 и CXL
Ускорители связываются с хост-процессорами по интерфейсу PCIe Gen 5 со скоростью 32 ГТ/с, а также по Gen 6 (64 ГТ/с) и появляющемуся стандарту CXL 3.0 на платформах нового поколения. Каждое поколение уменьшает бюджет вносимых потерь (insertion loss) вдвое и удваивает чувствительность к неоднородностям импеданса, делая канал на печатной плате тем самым элементом, ограничивающим производительность, который решает, достигнет ли система теоретической пиковой пропускной способности или перейдет на более низкие скорости соединения (link speeds).PCIe Gen 6 впервые внедряет сигнал PAM4 в стандарт PCIe, снижая бюджет потерь канала примерно до 20 дБ, из которых на долю печатной платы должно приходиться не более 6–8 дБ, включая все переходы через vias (via transitions), неоднородности конденсаторов развязки по переменному току и интерфейсы разъемов. На частоте Найквиста 32 ГГц важен каждый шаг: неоптимальный переход от переходного отверстия к полосковой линии (stripline) добавляет 1–2 дБ потерь, и четыре таких перехода в типичном канале могут «съесть» половину допустимых потерь печатной платы.
Оптимизация канала PCIe Gen 5/Gen 6
- Распределение бюджета потерь: Стандарт Gen 5 предусматривает общий предел потерь в канале ~28 дБ, при этом доля печатной платы должна составлять не более 8–10 дБ. Gen 6 ужесточает требования до ~20 дБ, ограничивая долю PCB 6–8 дБ, что делает обязательным удаление отростков vias (обратное высверливание до <6 мил), использование сверхнизкопотерьного диэлектрика (Df < 0,002 при 15 ГГц) и меди HVLP на всех сигнальных слоях.
- Проектирование перехода Vias: Каждый переход между слоями добавляет 0,5–2,0 дБ на частотах 16–32 ГГц в зависимости от геометрии via. Высверленные сквозные отверстия (back-drilled through-holes), глухие/зарытые vias (blind/buried) и оптимизированная геометрия антипадов (anti-pad) между via и трассой моделируются по отдельности с помощью 3D-электромагнитной симуляции и подтверждаются измерениями TDR на серийных платах.
- Поддержка расширения памяти CXL: Соединения CXL 2.0/3.0 используют физический уровень PCIe, но требуют более строгого допуска по джиттеру: протокол когерентности кеша CXL менее терпим к задержкам повторной передачи данных, чем модель «posted write» в PCIe, что делает запас целостности сигнала критически важным для архитектур пулов памяти (memory pooling) с интерфейсом CXL.
- Проверка на соответствие глаз-диаграммы: Измерение глаз-диаграммы (eye diagram) на платах первой производственной партии выполняется на скоростях 32 ГТ/с (Gen 5) и 64 ГТ/с (Gen 6) с использованием калиброванного BERT и осциллографа — для подтверждения соответствия серийного канала маске стандарта с документально подтвержденным запасом. Измерения глаз-диаграммы проводятся при рабочей температуре, а не только при комнатной.
Тепловая архитектура при длительной полной нагрузке
Платы для параллельных вычислений работают на максимальной мощности часами или сутками — сеансы обучения LLM-моделей могут длиться неделями, рендеринг заставляет GPU работать на пике часами, а научные симуляции продолжаются вплоть до достижения конвергенции. Тепловой дизайн должен справляться с непрерывной полной нагрузкой при расчетной температуре окружающей среды (35–45°C на входе в стойки дата-центра) без снижения тактовой частоты (троттлинга) или сокращения срока службы компонентов (менее 5 лет — стандартный цикл замены в ЦОДах).Проблема охлаждения печатных плат для параллельных вычислений заключается не просто в отводе общего количества тепла, а в борьбе с плотностью теплового потока (power density). Кристалл GPU мощностью 700 Вт имеет площадь около 800 мм², концентрируя тепловыделение более 87 Вт/см² на своей поверхности. Печатная плата должна проводить это тепло сквозь подложку корпуса, через термоинтерфейс (TIM) в радиатор (heatsink) или холодную пластину (cold plate) системы жидкостного охлаждения — и любые зазоры, пустоты (voids) или деформации (warpage) на этом тепловом пути создают «горячую точку» (hot spot), что приводит к локальному троттлингу и снижению суммарной вычислительной пропускной способности.
Тепловое проектирование для устойчивых нагрузок
- Архитектура тепловых переходных отверстий (Thermal Via) процессора: Плотные массивы тепловых vias (диаметром 0,3 мм с шагом 1,0 мм) под корпусами GPU/FPGA соединяют область BGA-контактов на верхней стороне платы с медным полигоном (copper pour) на нижней стороне, контактирующим с радиаторами через TIM. Заполнение vias (медью или токопроводящей эпоксидной смолой) и планаризация поверхности до ±10 мкм гарантируют стабильный контакт с TIM по всей площади установки компонента.
- Тепловое управление VRM: 16–24 фазы дросселей, каждая из которых рассеивает по 2–4 Вт, формируют распределенные источники тепла, генерирующие в сумме 30–60 Вт потерь VRM. Зонирование при размещении компонентов удерживает VRM на противоположном крае платы от чувствительных к температуре кварцевых генераторов (clock oscillators), источников опорного напряжения и датчиков I²C, обеспечивая терморазвязку не менее 15 мм.
- Контроль деформации (Warpage) под термической нагрузкой: Удержание деформации платы ниже 0,3% по диагонали за счет симметричного распределения меди на всех слоях, сбалансированной последовательности ламинирования и выбора препрега/ядра (prepreg/core) со скоординированным коэффициентом теплового расширения (CTE) — это исключает потерю контакта TIM, из-за которой теплопроводность в точке разрыва может снизиться в 3–5 раз.
- Внутреннее распределение тепла (Heat Spreading): Внутренние плоскости из меди толщиной 3–4 унции (oz) рассеивают тепло в стороны от концентрированных областей под кристаллами (die footprints), снижая разницу между пиковой и средней температурой в зоне монтажа корпуса. Тепловые модели (thermal simulation) верифицируются с помощью инфракрасной (IR) термографии на первых серийных образцах при непрерывной полной нагрузке.
DFM для производства 20–32-слойных плат ускорителей
Печатные платы (PCB) для параллельных вычислений относятся к числу самых сложных коммерческих плат, выпускаемых в настоящее время: от 20 до 32 слоев, в которых последовательное HDI-прессование (ламинирование) сочетается со сквозными отверстиями, силовые слои из толстой меди соседствуют с тонкими трассами (fine-line) для высокоскоростных сигналов, а материалы со сверхнизкими потерями требуют специализированных температурных профилей прессования. Выход годных плат (manufacturing yield) полностью зависит от соблюдения принципов проектирования с учетом технологичности (DFM) на этапе разработки, а также от реальных возможностей производителя, подтвержденных статистическими данными технологического процесса, а не рекламными заявлениями.Производственные мощности HILPCB позволяют изготавливать платы до 64 слоев для самых требовательных конструкций; для 28-32-слойных плат-ускорителей применяются производственные процессы, обеспечивающие процент выхода годных плат (first-pass yield) с первого прохода >92%. В рамках DFM-экспертизы мы выявляем взаимодействия производственных рисков, которые стандартные автоматизированные проверки правил проектирования (DRC) могут упустить: взаимосвязь между силами коробления (warpage), вызванными толстой медью, смещением слоев при последовательном ламинировании (registration drift), позиционной точностью обратного высверливания (back-drill) и чувствительностью ультранизкопотерьных материалов к температуре ламинирования.
Процесс DFM для сложных плат-ускорителей
- Точность совмещения при последовательном ламинировании: Точность от слоя к слою (layer-to-layer) ±1,5 мил (mil) при производстве 20–32 слоев, проверяемая по рентгеновским меткам совмещения при каждом цикле ламинирования — это исключает смещение между переходным отверстием (via) и контактной площадкой (pad) на участках трассировки (escape routes) HBM BGA с шагом 0,55 мм, где смещение всего на 2 мила приводит к обрыву цепи (open circuit).
- Контроль глубины обратного высверливания (Back-Drill): Отростки отверстий (via stubs) контролируются на глубине <6 мил с помощью обратного высверливания, совмещенного лазером (laser-registered back-drilling), с промежуточной проверкой глубины по результатам микрошлифов (cross-section) на каждой 50-й панели — каждый избыточный мил отростка создает четвертьволновой резонанс, образующий провал (notch) в частотной характеристике канала.
- Анализ баланса меди (Copper Balance Analysis): Распределение толстых силовых медных слоев (4-6 унций) анализируется на изгиб/кручение (bow/twist) с помощью метода конечных элементов — асимметричное распределение меди создает коробление свыше 0,5%, что снижает точность размещения компонентов и ухудшает тепловой контакт (thermal interface contact).
- Подтверждение совместимости материалов: Смешанные структуры (слои сверхнизкопотерьных сигналов со стандартными силовыми слоями FR-4) проверяются на совместимость при ламинировании — расхождение КТР (CTE) между разнородными материалами вызывает межслойное напряжение (inter-layer stress), способное привести к расслоению в ходе термоциклирования (thermal cycling).
- Проверка прототипов: Платы первой партии проходят полную электрическую верификацию (TDR, VNA, глаз-диаграммы), анализ микрошлифов (cross-section) и тепловые испытания до запуска основной серии — критически важный шаг, учитывая, что респин (respin — повторный выпуск) обойдется более чем в 80 000 долларов и приведет к задержке в графике на 8–10 недель.
Производство печатных плат для параллельных вычислений HILPCB
HILPCB производит печатные платы параллельных вычислений для OEM-производителей GPU-ускорителей, интеграторов FPGA, компаний по инфраструктуре обучения ИИ и операторов ЦОД в Северной Америке, Европе и Азиатско-Тихоокеанском регионе.Наши возможности по производству печатных плат для параллельных вычислений включают последовательное HDI-ламинирование до 64 слоев с точностью совмещения ±1,5 мил, толстые медные слои питания (4-6 унций) с многофазной трассировкой VRM для обеспечения мощности >800 А, диэлектрики со сверхнизкими потерями (Df < 0,002 на частоте 15 ГГц) для PCIe Gen 5/6, CXL и GDDR7, поддержка интерпозеров HBM3e с шагом выводов BGA 0,55 мм и трассировкой 2/2 мил, контроль деформации платы (менее 0,3%) при непрерывной тепловой нагрузке, а также изготовление по стандарту IPC-6012 класс 3 с полной отслеживаемостью партий и верификацией импеданса PDN каждого изделия с помощью векторного анализатора цепей (VNA).
Разрабатываете ли вы графический ускоритель нового поколения или масштабируете инфраструктуру обучения ИИ, наша команда инженеров работает рука об руку с вашей группой разработчиков на этапах от формирования стека слоев (stackup) до запуска серийного производства (production ramp), гарантируя, что технологические возможности подтверждены еще до утверждения топологии платы (layout commitment), а не обнаружатся на этапе испытаний первой производственной партии (first-article testing).
Вопросы и ответы о печатных платах для параллельных вычислений (FAQ)
Как печатные платы для параллельных вычислений справляются с подачей питания в 800 А?
Для передачи более 800 Ампер требуются внутренние слои из толстой меди (4-6 унций) и 16-24-фазные регуляторы напряжения (VRM), размещенные максимально близко к процессору. Сеть распределения питания (PDN) должна проектироваться с использованием полного 3D электромагнитного моделирования (full-wave) для удержания импеданса ниже 0,5 мОм на частотах до 500 МГц, что предотвращает скачки напряжения (voltage droop) при переходных процессах.
Почему длина отростка сквозного отверстия (via stub) критична для сигналов 112G PAM4?
На частоте 112G PAM4 (частота Найквиста 56 ГГц) остаточные отростки отверстий (via stubs) выступают в качестве резонирующих антенн, которые поглощают энергию сигнала и создают сильные "провалы" (notches) в частотной характеристике канала. Использование технологии обратного высверливания (back-drilling) для получения остаточного отростка длиной <6 мил (mils) является обязательным требованием для сохранения узкой "глаз-диаграммы" PAM4.
Что вызывает деформацию (warpage) плат в GPU-картах ускорителей?
Коробление (warpage) в основном вызвано асимметричным распределением меди, в частности, использованием толстых медных слоев для передачи больших токов, в сочетании с экстремальным термоциклированием рабочих нагрузок мощностью 700 Вт. Мы контролируем коробление на уровне <0,3%, используя идеально сбалансированные стеки слоев (stackups), симметричную заливку медью (copper pours) и материалы с согласованным коэффициентом теплового расширения (CTE).
Закажите техническую экспертизу (engineering review) для вашей программы создания плат ускорителей →