
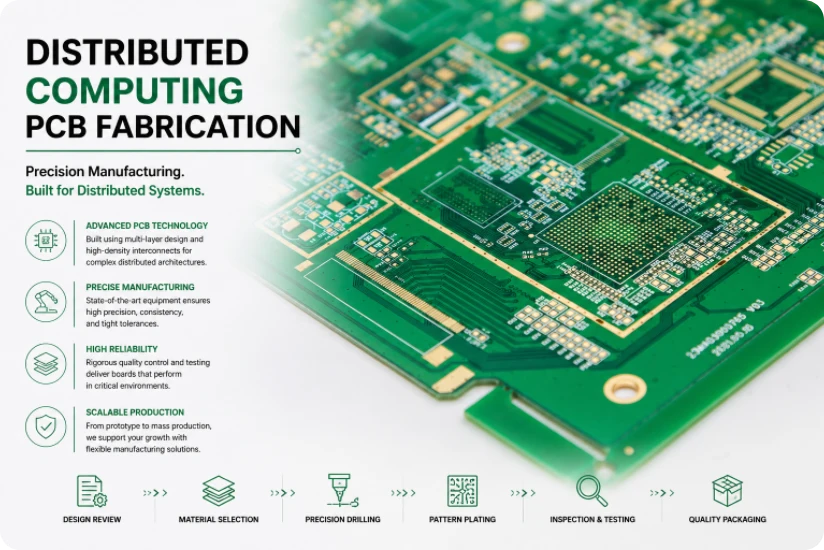
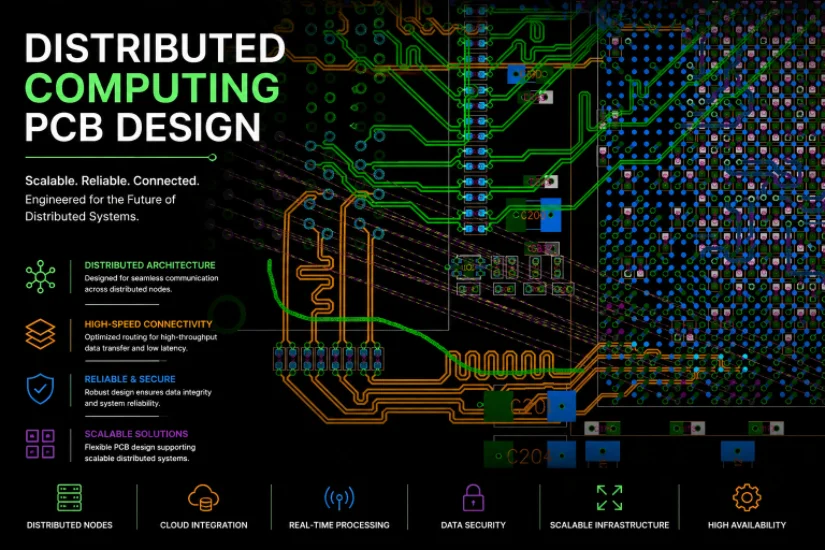
Le marché mondial du calcul distribué a dépassé 5,8 milliards de dollars en 2024. Les infrastructures blockchain, les réseaux de diffusion de contenu (CDN) et le calcul scientifique ont besoin de cartes produites en volume avec une dispersion suffisamment faible pour ne pas devenir une limite système. Une charge distribuée s’exécute sur des dizaines ou des milliers de nœuds, chacun doté de son processeur et de sa mémoire, puis coordonné par des liaisons rapides et des protocoles tels que MPI, gRPC, libp2p ou le consensus RAFT. Dans cette architecture, le PCB du nœud de calcul distribué doit offrir des performances reproductibles sur toute la flotte : le nœud le plus lent peut limiter le cluster entier.
Cette exigence modifie la façon d’évaluer la qualité. Pour une carte serveur isolée, il suffit souvent de confirmer sa conformité aux spécifications. Pour une flotte, il faut également vérifier que la distribution statistique du nouveau lot reste cohérente avec les lots précédents. Une variation d’impédance de 3 % peut rester dans la tolérance individuelle tout en créant des écarts de performance entre nœuds. Lors d’une synchronisation de barrière MapReduce, un seul nœud retardataire peut alors immobiliser des milliers de secondes-processeur à chaque événement.
HILPCB a livré ces cartes par lots de 10 à 8 000 unités, avec un Cpk d’impédance supérieur à 1,33 et une variation de l’impédance du réseau de distribution d’alimentation inférieure à 0,5 % entre des lots produits sur 18 mois. Ce niveau de répétabilité statistique correspond à l’enjeu principal d’une infrastructure déployée à grande échelle.
Sommaire
- Pourquoi la cohérence de la flotte dépasse la conformité individuelle
- Concevoir les interconnexions RDMA 25G et 100G
- Synchroniser les horloges et router la mémoire DDR5
- Dimensionner l’alimentation et la thermique pour un service continu
- Maîtriser statistiquement la fabrication à l’échelle d’une flotte
- Passer du lot pilote à 5 000 cartes
Pourquoi la cohérence de la flotte dépasse la conformité individuelle
Chaque nœud doit être interchangeable en exploitation. Dans un réseau de validation blockchain, la latence du consensus dépend du validateur le plus lent. Dans un CDN, le nœud périphérique le moins performant peut déterminer le niveau de service de diffusion. Dans un cluster scientifique MapReduce, la synchronisation attend le dernier nœud ayant terminé sa partition.
Le respect de la spécification de chaque carte ne suffit donc pas : la cohérence de fabrication devient l’indicateur qualité prioritaire. Une dispersion de l’impédance modifie la vitesse de propagation des signaux et les marges temporelles d’un nœud à l’autre. Une dispersion de l’impédance du réseau d’alimentation entraîne des chutes de tension différentes et donc un comportement variable de la fréquence turbo du processeur. Une dispersion thermique crée, elle, des seuils de limitation de fréquence différents dans la flotte.
Paramètres de fabrication critiques pour la cohérence entre cartes
- Contrôle statistique de l’impédance : suivre par SPC chaque réseau à impédance contrôlée sur tous les lots, au-delà d’un simple verdict conforme/non conforme. Une population avec Cpk > 1,33 et une détection de dérive doit déclencher le réglage du procédé avant qu’une carte sorte de la spécification. Les historiques interlots permettent d’évaluer la stabilité à long terme.
- Uniformité de l’épaisseur de cuivre : maintenir ±5 % sur toutes les couches d’un panneau et entre les panneaux d’un même lot afin de conserver une résistance des plans d’alimentation et une capacité de diffusion thermique comparables d’une carte à l’autre.
- Répétabilité de l’assemblage : le placement CMS à ±25 µm, suivi d’une AOI sur 100 % des cartes, vérifie l’alignement des composants sur les pastilles sensibles. Un déplacement de 50 µm d’un condensateur de découplage 0402 modifie sa contribution inductive au réseau d’alimentation à une échelle mesurable sur une flotte.
- Traçabilité par numéro de série : associer à chaque carte le lot de stratifié, la feuille de cuivre, le bain de gravure, l’horodatage du profil de refusion et l’ensemble des résultats de test. Ces données permettent de rapprocher une variation constatée sur le terrain des paramètres de fabrication d’une flotte de plusieurs milliers de cartes.
Conception PCB des interconnexions RDMA 25G et 100G
Le débit et la latence réseau influencent souvent davantage les performances distribuées que la puissance de calcul brute. Sur une charge très communicante, un nœud disposant de 20 % de capacité de traitement supplémentaire mais de 10 % de latence réseau en plus peut ralentir tout le cluster. Les nœuds modernes utilisent 25GbE ou 100GbE avec RDMA over Converged Ethernet (RoCE v2). Le contournement du noyau réduit la surcharge de la pile logicielle et fait passer la latence de 50 µs avec TCP dans le noyau à moins de 2 µs avec un RDMA matériel.
Le trajet entre le complexe racine PCIe du processeur, les pistes, les vias, le connecteur et le PHY de l’interface réseau constitue le sous-système le plus critique pour les performances. C’est aussi celui qui réagit le plus aux variations de fabrication entre cartes.
Routage SerDes, connecteurs SFP28/QSFP28 et latence RDMA
- Routage SerDes 25G/100G : utiliser des paires différentielles à 25,78 Gbaud en NRZ pour le 25G ou à 26,5625 Gbaud en PAM4 pour le 100G, avec moins de 6 dB de perte d’insertion à la fréquence de Nyquist sur les couches internes en stripline. La cible est de 100 Ω ±5 % en différentiel et de moins de 1,5 mil de désalignement intrapaire. Un PCB haute vitesse en stratifié à pertes moyennes, Df ≤ 0,005 à 12,5 GHz, convient au 25G ; le 100G demande un matériau à faibles pertes, Df ≤ 0,003.
- Implantation SFP28/QSFP28 : router du connecteur au PHY selon SFF-8402 pour SFP28 et SFF-8665 pour QSFP28. Pour le 25G, la piste ne doit pas dépasser 130 mm, avec au plus deux transitions par via sur chaque paire et un moignon inférieur à 8 mil après contre-perçage.
- Optimisation de la latence RDMA : supprimer les ruptures d’impédance et les résonances de moignons responsables d’interférences intersymboles. Celles-ci réduisent l’ouverture de l’œil et créent une gigue dépendante des données qui augmente directement la latence au 99e centile observée par l’application.
- Connecteurs de fond de panier à insertion en force : maintenir une tolérance de perçage de ±2 mil et l’impédance contrôlée dans toute la transition du connecteur sur une carte multicouche. Cette maîtrise est essentielle aux architectures partageant stockage ou commutateur réseau sur un fond de panier.
Synchronisation PTP et architecture mémoire DDR5 du nœud de calcul
Les systèmes distribués coordonnent le classement des événements, le séquencement des transactions et l’acquisition synchrone des données. Les plateformes de négociation financière demandent une synchronisation à la microseconde avec PTP et horodatage matériel. Le contrôle industriel distribué exige une précision inférieure à la milliseconde avec PTP ou NTP. Le calcul scientifique doit synchroniser l’échantillonnage de plusieurs nœuds afin de corréler correctement les mesures dans le temps.
La précision réalisable dépend directement de l’oscillateur de référence, de la topologie de distribution d’horloge et de l’implémentation de l’horodatage PTP matériel sur la carte.
Horodatage IEEE 1588v2, oscillateurs TCXO/OCXO et routage DDR5
- Horodatage matériel IEEE 1588v2 : router l’entrée d’horloge PTP à impédance contrôlée avec un appariement de longueur de ±3 mil entre l’horloge de référence et le verrou d’horodatage. L’horodatage matériel permet une précision inférieure à 100 ns, contre plus de 1 ms avec un NTP uniquement logiciel. Pour une application financière exigeant moins de 1 µs, prévoir une entrée d’horloge maître PTP dédiée et un OCXO offrant ±5 ppb de maintien en cas de perte du GPS.
- Choix et isolation de l’oscillateur : employer un TCXO à ±0,5 ppm de -40 à +85 °C pour un nœud standard, ou un OCXO à ±5 ppb pour les applications financières et scientifiques sous la microseconde. L’oscillateur doit être placé à plus de 15 mm des composants dissipatifs et alimenté par une source filtrée afin d’éviter une dérive induite par la chaleur ou le bruit de commutation.
- Routage DDR5 pour les charges de calcul intensif : router 4 à 8 canaux DDR5 à 4 800–5 600 MT/s en topologie en chaîne, avec un appariement de ±1 mil dans chaque octet. La simulation avant routage doit valider les marges de nivellement en écriture pour toutes les configurations DIMM. L’intégrité du signal doit être confirmée en 1DPC comme en 2DPC sur un stratifié haute vitesse dont la tolérance Dk est maîtrisée à ±3 %.
- LPDDR5 soudée pour les nœuds compacts : un nœud dense 1U à 6 400 MT/s nécessite un PCB HDI avec vias dans les pastilles, microvias de 0,075 mm et pistes/espaces de 3/3 mil. Cette construction fournit la densité nécessaire pour sortir d’un boîtier au pas de 0,5 mm avec une précision d’alignement de ±15 µm.
Alimentation et thermique d’un nœud distribué en service continu
Un nœud distribué peut fonctionner 24 h/24 et 365 jours/an pendant 5 à 10 ans sous charge soutenue. Contrairement à un équipement périphérique intermittent ou à un serveur cloud soumis à une charge mutualisée variable, un nœud de validation blockchain, de traitement CDN ou de calcul scientifique peut rester proche de sa dissipation maximale. Une conception thermique ne gardant que 5 °C de marge au-dessus de la température continue favorise le vieillissement des composants, la fatigue des brasures puis une défaillance susceptible d’affecter le système entier.
Cuivre épais, vias thermiques et endurance sur 5 à 10 ans
- Distribution de puissance en cuivre épais : un processeur multicœur de 125–350 W TDP nécessite un VRM multiphase et des couches internes de cuivre épais de 2–4 oz pour limiter la chute de tension et l’échauffement résistif. L’épaisseur se dimensionne par rail ; une même carte peut employer 3 oz sur le Vcore et 1 oz sur les couches d’entrées-sorties pour concilier puissance et densité de routage.
- Architecture des vias thermiques : placer sous le processeur et les étages du VRM des vias remplis et recouverts IPC-4761 type VII, de 0,3 mm de diamètre au pas de 0,8 mm. Ils conduisent la chaleur vers le dissipateur inférieur sans aspiration de brasure pendant l’assemblage. Le cuivre ou l’époxy thermoconducteur est choisi selon la conductivité requise pour le TDP concerné.
- Matériaux pour dix ans de service : valider un FR-4 à Tg élevée, Tg ≥ 175 °C et Td ≥ 350 °C, par 10 000 heures de vieillissement accéléré à la température continue prévue. La résistance aux filaments anodiques conducteurs doit être contrôlée pendant 1 000 heures à 85 °C/85 % HR sous tension nominale afin de prévenir les migrations électrochimiques apparaissant après 3 à 4 ans.
- Endurance des brasures : qualifier les joints SAC305 sur plus de 3 000 cycles thermiques selon IPC-9701 en condition d’alimentation continue. Cela représente trois fois la qualification habituelle de 1 000 cycles pour une infrastructure toujours active.
Contrôle statistique de la fabrication PCB à l’échelle d’une flotte
Une variation imperceptible sur une carte isolée peut devenir visible sur des milliers de nœuds. Une dérive d’impédance de 3 % entre lots modifie le comportement de la fréquence turbo du processeur. Une variation de cuivre de 5 % change la résistance thermique. Une légère dérive du profil de refusion peut produire un groupe de cartes dont les brasures cèdent 18 mois avant celles du reste de la flotte.
SPC, contrôle des matériaux et verrouillage du procédé d’assemblage
- SPC en temps réel : suivre automatiquement l’impédance par TDR sur chaque panneau, l’épaisseur de cuivre par microsection à chaque lot, l’alignement du perçage aux rayons X, le facteur de gravure et le volume de pâte à braser. Les règles de Western Electric doivent détecter une tendance deux à trois lots avant la production de cartes hors tolérance.
- Vérification des lots de matière entrants : mesurer Dk et Df à 10 GHz sur chaque lot de stratifié avec un résonateur diélectrique à poteaux séparés. Un lot doit être refusé si ses propriétés déplacent l’impédance contrôlée hors de la cible de conception, même lorsqu’il reste conforme à sa propre fiche technique.
- Verrouillage du procédé après qualification : figer les profils de refusion, programmes de placement, type de pâte, pochoir et critères d’inspection après le lot pilote. Toute modification, y compris un changement de lot de pâte, doit entraîner une requalification formelle afin d’éviter une dérive non maîtrisée.
- Validation d’une présérie : produire 50 à 200 cartes avec caractérisation électrique complète, analyse statistique de l’impédance et essais thermiques accélérés. Cette étape valide le procédé et quantifie le rendement avant le lancement du volume série.
Du lot pilote à la production de 5 000 cartes de nœuds
La stratégie de test doit détecter les défauts systémiques avant le déploiement. Un défaut latent présent sur 1 % des cartes représente 50 nœuds défaillants dans un cluster de 5 000 unités. Chacun peut déclencher un rééquilibrage des charges, une migration des données et une dégradation du service.
Tests de production, déverminage et montée en volume
- Boundary Scan JTAG sur 100 % des cartes : vérifier les connexions brasées de chaque BGA, QFN et composant à pas fin, dont les joints cachés ne sont pas accessibles à l’inspection visuelle.
- Vérification de l’intégrité du signal sur les premières pièces : mesurer au TDR les profils d’impédance et le diagramme de l’œil aux débits réels, notamment 25G NRZ et DDR5. Les résultats doivent confirmer que le canal fabriqué respecte les objectifs de la simulation avant routage.
- Déverminage de 48 à 72 heures à température élevée : faire fonctionner la carte sous charge de calcul synthétique à 55 °C ambiants, contre 35 °C nominaux, afin de solliciter les mécanismes de défaillance précoce et de dépasser la première zone de la courbe en baignoire avant déploiement.
- Production de flotte clé en main : intégrer l’approvisionnement, la fabrication, l’assemblage, les tests, le déverminage, la sérialisation et la logistique pour maintenir qualité et traçabilité du pilote de 10 cartes jusqu’au lot de 8 000 unités.
Questions fréquentes sur les PCB de calcul distribué
Pourquoi la cohérence d’impédance est-elle critique dans une flotte de nœuds ?
Dans un cluster distribué, le nœud le plus lent peut limiter les performances globales. Une dispersion d’impédance modifie les vitesses de propagation et crée des écarts temporels entre cartes. Une cohérence statistique avec Cpk > 1,33 contribue à maintenir un comportement homogène sur plusieurs milliers d’unités.
Quelles exigences PCB faut-il prévoir pour une interconnexion RDMA ?
Un réseau 25G/100G RoCE exige une latence très faible et peu de pertes de paquets. La carte doit associer un stratifié à faibles pertes, des paires différentielles précises — par exemple 100 Ω ±5 % — et des vias contre-percés pour supprimer les résonances de moignons. Cela limite les interférences intersymboles responsables de gigue et de pointes de latence.
Comment un PCB de nœud distribué supporte-t-il une charge thermique continue ?
Un nœud peut rester proche de sa puissance maximale en permanence. La carte utilise alors des couches internes de cuivre épais de 2–4 oz pour répartir latéralement la chaleur, des réseaux denses de vias thermiques sous les composants dissipatifs et un matériau à Tg élevée pour limiter la dégradation du diélectrique sous contrainte thermique prolongée.
Demander un chiffrage pour votre flotte de nœuds de calcul distribué →