

Il mercato globale del GPU computing ha raggiunto i 52,4 miliardi di dollari nel 2024, con i carichi di lavoro (workloads) di addestramento e inferenza dell'IA che hanno trainato un aumento del 38% su base annua della domanda di schede acceleratrici. Il calcolo parallelo esegue migliaia di operazioni simultaneamente: le GPU elaborano i livelli delle reti neurali attraverso 16.384 core CUDA, gli FPGA eseguono pipeline di inferenza personalizzate a velocità di linea (wire speed) e i processori chiplet multi-die suddividono le simulazioni di fluidodinamica su oltre 128 thread. Il PCB per il calcolo parallelo deve fornire una larghezza di banda della memoria estrema che supera i 3 TB/s, un'erogazione di potenza (power delivery) di diverse centinaia di watt con un'impedenza della rete di distribuzione dell'alimentazione (PDN) inferiore al milliohm, e un'integrità del segnale per le interfacce 112G PAM4: il tutto all'interno di vincoli termici e meccanici che spingono la fabbricazione dei PCB ai suoi limiti assoluti.
Il boom dell'addestramento dell'IA ha reso i PCB per il calcolo parallelo il segmento in più rapida crescita nella fabbricazione di schede ad alte prestazioni. Le schede acceleratrici NVIDIA H100/H200 e AMD MI300X richiedono costruzioni a 20-32 strati con laminazione HDI sequenziale, piani di alimentazione in rame pesante da 4-6 once e perdite di canale (channel losses) sufficientemente contenute da supportare la segnalazione 112G PAM4. HILPCB produce PCB per calcolo parallelo fino a 64 strati (incluse schede a 28 strati con 6 once di rame che trasportano oltre 800 A ai package dei processori) per OEM di acceleratori GPU e FPGA e integratori di sistemi che implementano l'addestramento dell'IA e l'infrastruttura HPC nei data center di tutto il mondo.
Navigazione Menu
- Perché il Calcolo Parallelo Crea Esigenze PCB Estreme
- Architettura di Erogazione di Potenza per Schede Acceleratrici da 700W+
- Routing dell'Interfaccia di Memoria HBM3e e GDDR7
- Integrità del Segnale delle Interconnessioni PCIe Gen 5/Gen 6 e CXL
- Architettura Termica a Pieno Carico Sostenuto
- DFM per la Fabbricazione di Schede Acceleratrici a 20–32 Strati
- Fabbricazione di PCB per Calcolo Parallelo HILPCB
Perché il Calcolo Parallelo Crea Esigenze PCB Estreme
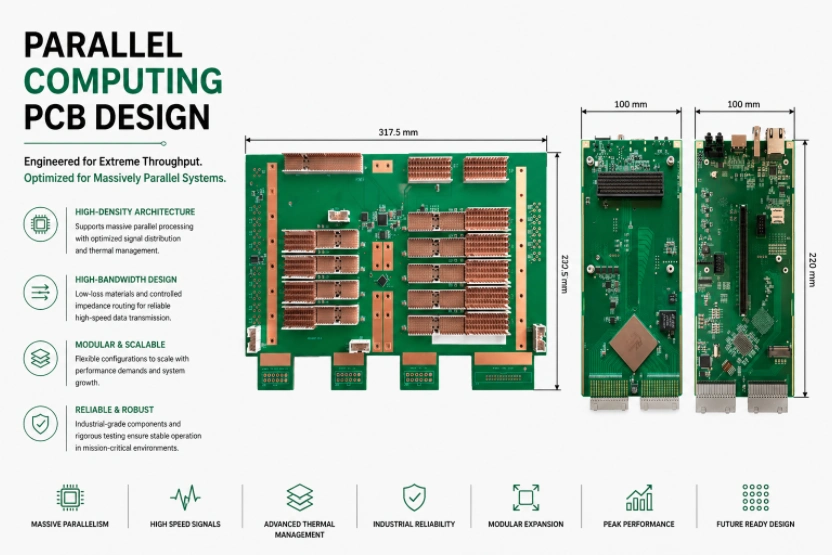
Un acceleratore GPU della generazione attuale concentra 700 W di potenza, 3,35 TB/s di larghezza di banda della memoria HBM3e e 128 corsie (lanes) di PCIe Gen 5/CXL 2.0 in un singolo PCB che misura circa 267×112 mm. Queste esigenze si sommano contemporaneamente in ogni dominio di progettazione: erogazione di potenza, integrità del segnale, gestione termica e stabilità meccanica operano tutte ai propri limiti fisici assoluti con un margine di errore pari a zero per la variabilità di fabbricazione.La sfida tecnica non risiede in un singolo parametro isolato, ma nell'interazione tra di essi. I piani in rame pesante necessari per l'erogazione di 800 A creano discontinuità di impedenza che interferiscono con il routing del segnale 112G PAM4 adiacente. Gli array di via termici necessari per l'estrazione del calore consumano i canali di routing richiesti per l'uscita (escape routing) dell'HBM3e. Le zone di posizionamento degli induttori del modulo di regolazione della tensione (VRM) multifase entrano in conflitto con le aree di esclusione (keepout) dei bus di memoria ad alta velocità. Risolvere queste interazioni richiede una revisione della progettazione coordinata e multidominio, che pochi fabbricanti hanno l'esperienza necessaria per eseguire.
Il programma PCB per il calcolo parallelo di HILPCB affronta queste sfide cumulative attraverso una co-progettazione simultanea potenza-segnale-termica, identificando e risolvendo i conflitti tra le geometrie dei piani di alimentazione, i canali di routing ad alta velocità e gli array di via termici prima che raggiungano la fabbricazione.
Sfide Caratterizzanti nella Progettazione di PCB per Calcolo Parallelo
- Concentrazione di Potenza: Oltre 800 A a tensioni di core inferiori a 0,75 V con ripple < 5 mV in presenza di transitori di 200 A/μs. Ciò richiede VRM a 16-24 fasi con piani in rame pesante (4-6 once interni) che non devono creare discontinuità di impedenza per il routing del segnale 112G adiacente.
- Larghezza di Banda della Memoria ai Limiti del Substrato: Interfacce HBM3e a 9,6 Gbps per pin su bus a 1024 bit e GDDR7 a 36 Gbps per pin che utilizzano la segnalazione PAM4. A queste velocità di trasmissione dei dati, la perdita dielettrica (Df) del PCB e la rugosità del rame sono i principali fattori limitanti della larghezza di banda, non la velocità del silicio.
- Stress Meccanico Sotto Carico Termico: Deformazione della scheda (warpage) inferiore allo 0,3% della diagonale sotto un carico termico sostenuto di 700 W. Ciò previene la perdita di contatto con il materiale di interfaccia termica (TIM), l'affaticamento delle saldature BGA e lo sganciamento dei connettori PCIe durante sessioni di addestramento (training runs) di più giorni.
- Complessità di Fabbricazione su Larga Scala: 20-32 strati che mescolano la laminazione HDI sequenziale con via passanti (through-hole vias), piani di alimentazione in rame pesante da 4-6 once e routing di segnale trace/space da 3/3 mil su dielettrici a bassissima perdita (ultra-low-loss). Queste sfide di rendimento (yield) richiedono un'esperienza di fabbricazione che elimini il tasso di scarto del 30-40% tipico dei fabbricanti meno capaci.
Queste esigenze rendono i PCB per il calcolo parallelo tra le schede commerciali tecnicamente più difficili da produrre, e le più costose quando la qualità di fabbricazione non è all'altezza.
Architettura di Erogazione di Potenza per Schede Acceleratrici da 700W+
L'hardware parallelo assorbe livelli di potenza che competono con le apparecchiature industriali: una GPU di addestramento assorbe in modo continuo 700 W per giorni durante l'addestramento di Large Language Models (LLM), un array FPGA sostiene 400 W indefinitamente durante la transcodifica video in tempo reale e gli acceleratori di prossima generazione previsti dalla roadmap superano i 1000 W per scheda. Un'erogazione di potenza pulita a questi livelli determina se l'acceleratore raggiunge il suo throughput TFLOPS nominale o se subisce una riduzione delle prestazioni (throttling) a causa di una caduta di tensione indotta dai transitori (voltage droop), che può ridurre le prestazioni di addestramento del 15-20%.La sfida della progettazione della rete di distribuzione dell'alimentazione (PDN) è fondamentalmente diversa da quella delle schede server standard. Un die GPU che esegue una moltiplicazione di matrici su tutti i 16.384 core crea transitori di corrente che superano i 200 A/μs: una velocità tale che persino i piani di alimentazione ben progettati mostrano cadute di tensione a meno che il profilo di impedenza della PDN non sia piatto dalla corrente continua (DC) a 500 MHz. Ciò non richiede solo rame pesante, ma geometrie dei piani progettate con precisione e un posizionamento di disaccoppiamento validato tramite simulazione elettromagnetica a onda intera (full-wave).
Ingegneria PDN per Acceleratori Paralleli
- Layout VRM Multifase: Convertitori step-down (buck) a 16-24 fasi con stadi di potenza DrMOS e induttori posizionati entro 2 mm dalle ball di alimentazione del circuito integrato (IC). Loop di corrente di fase instradati su strati di rame pesante (4-6 once interni, 6-10 once esterni su moduli di alimentazione dedicati) mantenendo l'induttanza del loop (loop inductance) al di sotto di 80 pH per fase.
- Partizionamento dei Piani di Alimentazione su Strati Dedicati: Piani di rame separati e ininterrotti per la tensione di core (0,65-0,85 V), HBM I/O (1,05 V), SerDes (0,9 V) e rail ausiliari: ciascuno su piani multistrato dedicati senza alcuna penetrazione di via di segnale. Geometrie anti-pad attorno ai via di segnale ottimizzate tramite solver di campo 3D (3D field solver) per prevenire picchi di impedenza localizzati nei piani di alimentazione.
- Disaccoppiamento Distribuito per Obiettivo di Impedenza: Da 400 a 800 condensatori posizionati in base a simulazioni di impedenza PDN full-wave, e non secondo regole pratiche (rule-of-thumb), mantenendo l'impedenza PDN al di sotto di 0,5 mΩ dalla DC fino a 500 MHz. Le connessioni dei via dalle piazzole dei condensatori ai piani di alimentazione/massa utilizzano via-in-pad con stub retro-perforati (back-drilled) per ridurre al minimo il contributo ESL.
- Telemetria della Corrente in Tempo Reale: Reti di resistori shunt ad alta precisione (tolleranza ±0,5%, connessione Kelvin a 4 terminali) su ciascun rail principale, che forniscono misurazioni della potenza in tempo reale con una precisione del ±1%: integrate nella gestione dell'infrastruttura del data center tramite PMBus/I²C per limitare la potenza della GPU e coordinare il throttling termico.
Processo Validato per l'Integrità dell'Alimentazione
Ogni scheda acceleratrice viene sottoposta a una misurazione dell'impedenza PDN utilizzando un analizzatore di reti vettoriali (VNA) da 100 Hz a 1 GHz, verificando che la scheda fabbricata soddisfi il profilo di impedenza target simulato in tutte le decadi di frequenza. Le schede che non superano la maschera di impedenza vengono scartate prima dell'assemblaggio dei componenti, evitando la costosa scoperta di problemi di power integrity durante l'integrazione del sistema.
Routing dell'Interfaccia di Memoria HBM3e e GDDR7
I processori paralleli raggiungono il loro throughput accedendo alla memoria attraverso bus estremamente ampi ed estremamente veloci. La HBM3e utilizza interfacce a 1024 bit a 9,6 Gbps per pin, fornendo 1,2 TB/s per stack (4,8 TB/s su quattro stack); la GDDR7 utilizza bus a 256 bit a 36 Gbps per pin utilizzando la segnalazione PAM4. Queste interfacce di memoria di nuova generazione definiscono il numero di strati (layer count) della scheda, il sistema dei materiali e la complessità del processo di fabbricazione, e spingono i substrati organici dei PCB ai loro limiti fisici fondamentali.A queste velocità di trasferimento dati, il PCB non è un'interconnessione passiva: contribuisce attivamente al tasso di errore in bit (BER) del canale di memoria. La perdita dielettrica (Df), la rugosità superficiale del rame (Rz) e la risonanza degli stub dei via contribuiscono ciascuna a una degradazione misurabile dell'apertura dell'occhio (eye opening). Un processo di fabbricazione che produce una variazione di Df di ±0,001 a 15 GHz (ben entro le tolleranze standard) può spostare il margine dell'occhio GDDR7 del ±15%, superando potenzialmente il limite di conformità JEDEC.
Tecniche di Routing della Memoria per Interfacce di Nuova Generazione
- Integrazione dell'Interposer HBM3e: Oltre 2000 sfere BGA (BGA balls) con un passo (pitch) di 0,55 mm, più stretto rispetto alle precedenti generazioni HBM, richiedono una costruzione HDI con laminazione sequenziale, microvia impilati (stacked microvias, perforati al laser da 0,075 mm) e traccia/spazio 2/2 mil per il routing di uscita (escape routing). Il via-in-pad con riempimento in rame e planarizzazione è obbligatorio per questa densità di sfere.
- Integrità del Segnale GDDR7 PAM4: La segnalazione PAM4 a 36 Gbps richiede una perdita di inserzione (insertion loss) inferiore a 2,5 dB alla frequenza di Nyquist di 18 GHz, rendendo necessari laminati a perdita ultra-bassa (Dk 3,0, Df 0,0015 a 10 GHz, come Panasonic Megtron 7 o Isola I-Speed) con foglio di rame HVLP (Rz < 1,5 μm) e coppie differenziali a impedenza controllata con lunghezza adattata (length-matched) entro ±0,5 mil per gruppo di byte.
- Simulazione del Canale Pre-Routing: Modelli di canale completi con parametri S estratti dallo stackup proposto utilizzando solver di campi elettromagnetici 3D (non approssimazioni 2D) verificano l'apertura dell'occhio rispetto ai requisiti della maschera JEDEC negli angoli di processo peggiori (worst-case process corners: Df massimo, rugosità del rame massima, spessore dielettrico min/max) prima dell'approvazione del layout.
- Gestione del Crosstalk ai Livelli di Tensione PAM4: Le tre aperture dell'occhio della tecnologia PAM4 hanno ciascuna un'ampiezza pari a un terzo del segnale NRZ, il che rende la tolleranza alla diafonia (crosstalk) più severa di 9,5 dB rispetto a NRZ per un BER equivalente. L'estrazione post-layout conferma che l'accoppiamento vicino (NEXT) e lontano (FEXT) tra i canali GDDR7 adiacenti rimane al di sotto di -35 dB, prevenendo il jitter dipendente dai dati (data-dependent jitter) che chiude i già ristretti margini dell'occhio PAM4.
Integrità del Segnale delle Interconnessioni PCIe Gen 5/Gen 6 e CXL
Gli acceleratori comunicano con i processori host attraverso PCIe Gen 5 a 32 GT/s, con la Gen 6 a 64 GT/s e l'emergente CXL 3.0 sulle piattaforme di nuova generazione. Ogni generazione dimezza il budget di perdita di inserzione (insertion loss) e raddoppia la sensibilità alle discontinuità di impedenza, rendendo il canale del PCB l'elemento limitante per le prestazioni, determinando se il sistema raggiunge il throughput di picco teorico o se ripiega su velocità di collegamento (link speeds) inferiori.Il PCIe Gen 6 introduce per la prima volta la segnalazione PAM4 nello standard PCIe, riducendo il budget di perdita del canale a circa 20 dB, dei quali il PCB non deve consumare più di 6-8 dB, comprese tutte le transizioni dei via, le discontinuità dei condensatori di accoppiamento AC e le interfacce dei connettori. Alla frequenza di Nyquist di 32 GHz, ogni decisione progettuale conta: una transizione subottimale da via a stripline aggiunge 1-2 dB, e quattro di tali transizioni in un canale tipico consumano metà dell'allocazione di perdita del PCB.
Ottimizzazione dei Canali PCIe Gen 5/6
- Allocazione del Budget di Perdita: La Gen 5 alloca un totale di ~28 dB per la perdita del canale con una quota riservata al PCB inferiore a 8-10 dB. La Gen 6 riduce questo valore a ~20 dB complessivi con il PCB sotto i 6-8 dB, imponendo l'eliminazione dei via stub (back-drilling <6 mil residui), dielettrici a bassissima perdita (ultra-low-loss, Df < 0,002 a 15 GHz) e rame HVLP su tutti i livelli di segnale.
- Ingegneria delle Transizioni dei Via: Ogni transizione di strato aggiunge 0,5-2,0 dB a 16-32 GHz a seconda della geometria del via. Fori passanti retro-perforati (back-drilled), via ciechi/interrati e geometrie anti-pad (via-to-trace) ottimizzate sono modellati individualmente attraverso simulazione elettromagnetica 3D e verificati tramite misurazione TDR (Time-Domain Reflectometry) sulle schede di produzione.
- Supporto per l'Espansione di Memoria CXL: I link CXL 2.0/3.0 condividono il livello fisico PCIe ma richiedono una tolleranza al jitter più stretta; il protocollo di cache-coherency del CXL è meno tollerante alla latenza di ritrasmissione rispetto al modello posted write del PCIe, rendendo il margine di integrità del segnale critico per le architetture di memory pooling collegate al CXL.
- Verifica di Conformità del Diagramma a Occhio: Le schede di pre-serie (first-article) sono sottoposte a misurazione del diagramma a occhio (eye diagram) a 32 GT/s (Gen 5) e 64 GT/s (Gen 6) tramite BERT calibrato e oscilloscopio, confermando che il canale di produzione rientri nella maschera di conformità (compliance mask) con un margine documentato. Le misurazioni a occhio vengono eseguite alla temperatura d'esercizio, non solo a temperatura ambiente.
Architettura Termica a Pieno Carico Sostenuto
Le schede per il calcolo parallelo operano alla massima potenza per ore o giorni: i cicli di addestramento LLM si protraggono per settimane, i job di rendering mantengono l'utilizzo di picco della GPU per ore e le simulazioni scientifiche vengono eseguite fino a convergenza. Il progetto termico deve gestire un carico massimo sostenuto alla temperatura ambiente nominale (35-45°C all'ingresso del data center) senza causare throttling termico o degradare la durata dei componenti al di sotto del ciclo di sostituzione quinquennale dei data center.La sfida termica sui PCB di calcolo parallelo non è semplicemente legata alla dissipazione di potenza totale, ma piuttosto alla densità di potenza (power density). Un die GPU da 700 W misura circa 800 mm², concentrando oltre 87 W/cm² sulla sua superficie. Il PCB deve condurre questo calore attraverso il substrato del package, l'interfaccia TIM (Thermal Interface Material), e fino al dissipatore o cold plate; ogni interstizio, micro-vuoto o deformazione (warpage) lungo questo percorso termico crea un punto caldo (hot spot) che attiva il throttling localizzato, riducendo le prestazioni computazionali complessive.
Progettazione Termica Sostenuta a Pieno Carico
- Architettura Via Termici dei Processori: Fitto array di via termici (diametro di 0,3 mm, passo di 1,0 mm) posizionati sotto i package GPU/FPGA per connettere la zona dei pad BGA (top-side) ai piani di rame sottostanti interfacciati ai dissipatori tramite TIM. Il riempimento dei via (copper fill o resina conduttiva) e la planarizzazione della superficie a ±10 μm garantiscono un contatto TIM uniforme sull'intera area del package (footprint).
- Gestione Termica dei VRM: Le 16-24 fasi dell'induttore, ognuna con perdite di 2-4 W, generano fonti di calore distribuite per un totale di 30-60 W di dissipazione VRM. La strategia di posizionamento mantiene i componenti VRM posizionati sul bordo opposto rispetto a oscillatori sensibili alla temperatura, riferimenti di tensione e sensori I²C, mantenendo un isolamento termico di ≥15 mm.
- Controllo della Deformazione (Warpage Control) Sotto Carico Termico: Limitazione della deformazione della scheda a <0,3% della sua diagonale mediante una distribuzione simmetrica del rame su tutti i layer, l'impiego di una sequenza di laminazione bilanciata, e l'adozione di prepreg/core bilanciati CTE; si evitano così cedimenti nel contatto TIM che ridurrebbero la conducibilità termica di 3-5 volte nel punto di distacco.
- Diffusione Interna del Calore (Internal Heat Spreading): I layer interni di rame da 3-4 once disperdono il calore lateralmente rispetto alle aree ad alta concentrazione energetica del die, riducendo il delta tra temperatura di picco e temperatura media nella zona di installazione del package. Risultati della simulazione termica validati con test di termografia a infrarossi sulle schede first-article a pieno carico sostenuto.
DFM per la Fabbricazione di Schede Acceleratrici a 20–32 Strati
I PCB di calcolo parallelo rientrano tra le schede commerciali in assoluto più complesse mai prodotte: da 20 a 32 strati (layer) in una struttura ibrida che combina laminazione HDI sequenziale e via passanti, l'impiego di piani di alimentazione in rame spesso accanto a tracce di segnale molto sottili (fine-line) e materiali dielettrici ultra-low-loss che necessitano di profili termici di laminazione rigorosi. Il tasso di rendimento finale (manufacturing yield) dipende esclusivamente dal rigore applicato in ambito DFM (Design for Manufacturability) e dalle capacità produttive del fornitore, validate esclusivamente attraverso misurazioni e analisi statistiche, non sulle dichiarazioni di marketing.HILPCB ha sviluppato una capacità costruttiva che si spinge sino a 64 layer per far fronte a stackup estremamente critici; sulle schede per acceleratori a 28-32 layer, garantiamo una percentuale di First-Pass-Yield pari a >92%. Il nostro team di ingegnerizzazione DFM si concentra proprio su quei punti ciechi che i tradizionali tool automatici di verifica (DRC) non catturano: l'interrelazione tra le tensioni indotte dallo spessore elevato del rame, lo slittamento dei registri (registration drift) nella laminazione sequenziale e il controllo millimetrico sul posizionamento per la fase di back-drill uniti alla delicatezza (termica) insita nei materiali in alta frequenza.
Processo DFM per Schede Acceleratrici Complesse
- Precisione di Registrazione nella Laminazione Sequenziale (Sequential Lamination Registration): Accuratezza di ±1,5 mil strato su strato nei build-up sequenziali di 20-32 strati, confermata da misurazioni ai raggi X in ciascun ciclo di laminazione per scongiurare il disallineamento dei via dai pad nelle reti di escape routing HBM BGA con passo di 0,55 mm, in cui l'offset di soli 2 mil provoca interruzioni di circuito (open circuit).
- Controllo di Profondità per il Back-Drill (Back-Drill Depth Control): Minimizzazione degli stub dei via a <6 mil (valore residuo) impiegando back-drill allineato a laser e convalidato in-process da test a sezioni incrociate condotte ogni 50 panel; un solo mil eccedente causa l'insorgenza della risonanza a un quarto d'onda che provoca crolli di attenuazione drastici e repentini nelle frequenze d'impiego.
- Analisi di Bilanciamento Rame (Copper Balance Analysis): Ottimizzazione del rame per le power layer da 4-6 oz analizzando le potenziali distorsioni a torsione e inarcamento (bow/twist) attraverso la simulazione con elementi finiti; uno squilibrio del bilanciamento del rame causerà distorsioni superiori a >0.5% (warpage), influenzando negativamente sia la fase d'inserimento del componente che l'aderenza sulle superfici dissipatrici in area Thermal.
- Controllo Compatibilità Materiale: Verifica per il match sulle dilatazioni termiche per stack-up costruiti in mix (ad es. per miscelazione di substrati a ultra-low-loss accoppiati a layers d'alimentazione in comune FR-4) per prevenire l'avvento di danni delaminativi tra strato e strato nel superamento degli stress nei cicli termici in virtù al disallineamento sul coefficiente (CTE).
- Validazione dei Prototipi: Test delle unità pre-serie (first-articles) supportate da completa validazione elettrica (TDR, VNA, misurazioni a occhio), analisi incrociata per la sezione in spessore ed estese prove termiche - step estremamente critico se il re-spin costa ben $80.000 con ripercussioni negative da 8-10 settimane d'arresto alla commessa.
Fabbricazione di PCB per Calcolo Parallelo HILPCB
HILPCB produce PCB per il calcolo parallelo per OEM di acceleratori GPU, integratori FPGA, aziende di infrastrutture per l'addestramento AI e operatori di data center in Nord America, Europa e Asia-Pacifico.Le nostre capacità di fabbricazione per schede di calcolo parallelo includono la laminazione sequenziale HDI fino a 64 strati con registrazione di ±1,5 mil, piani di alimentazione in rame pesante da 4-6 once con routing VRM multifase in grado di erogare 800+ A, dielettrici a bassissima perdita (ultra-low-loss, Df < 0,002 a 15 GHz) per PCIe Gen 5/6, CXL e GDDR7, supporto per interposer HBM3e con escape routing per BGA con passo da 0,55 mm a 2/2 mil traccia/spazio, controllo del warpage al di sotto dello 0,3% sotto carico termico sostenuto, e fabbricazione IPC-6012 di Classe 3 con tracciabilità completa dei lotti e impedenza PDN verificata tramite VNA su ogni scheda in produzione.
Che si tratti dello sviluppo dell'acceleratore GPU di nuova generazione o del ridimensionamento (scaling) dell'infrastruttura di addestramento AI, il nostro team di ingegneri collabora fianco a fianco con il vostro gruppo di progettazione dalla definizione dello stackup fino all'avvio della produzione (production ramp), assicurandosi che la capacità di fabbricazione sia validata prima di finalizzare il layout e non riscontrata in fase di collaudo del primo prototipo (first-article).
Domande Frequenti sui PCB per Calcolo Parallelo
In che modo i PCB per il calcolo parallelo gestiscono l'erogazione di potenza a 800 A?
Fornire oltre 800 Ampere richiede piani interni in rame pesante (4-6 once) e VRM a 16-24 fasi posizionati il più vicino possibile al processore. La rete di distribuzione dell'alimentazione (PDN) deve essere progettata avvalendosi di simulazioni elettromagnetiche 3D a onda intera per mantenere l'impedenza al di sotto di 0,5 mΩ fino a 500 MHz, scongiurando in tal modo temporanee cadute di tensione.
Perché la lunghezza dello stub dei via è critica per i segnali 112G PAM4?
A 112G PAM4 (Nyquist a 56 GHz), gli stub dei via (via stubs) si comportano come antenne risonanti in grado di assorbire l'energia del segnale, originando profonde cadute (notches) nella risposta in frequenza del canale. L'operazione di back-drilling per rimuoverli fino a un residuo <6 mil è obbligatoria per preservare le già ridotte finestre di apertura (eye diagram) tipiche della segnalazione PAM4.
Cosa provoca la deformazione della scheda (warpage) nelle schede acceleratrici GPU?
La deformazione (warpage) è originata in prevalenza dalla ripartizione asimmetrica del rame, in particolar modo sui piani ispessiti per sostenere correnti importanti, che si combina alle escursioni termiche estreme (heat cycling) dovute ai carichi da 700 W. Contrattiamo la deformazione a <0,3% impiegando stack-up meticolosamente bilanciati, colate di rame (copper pour) simmetriche e materiali abbinati in termini di CTE.
Richiedi una revisione tecnica per il tuo programma di schede acceleratrici →