
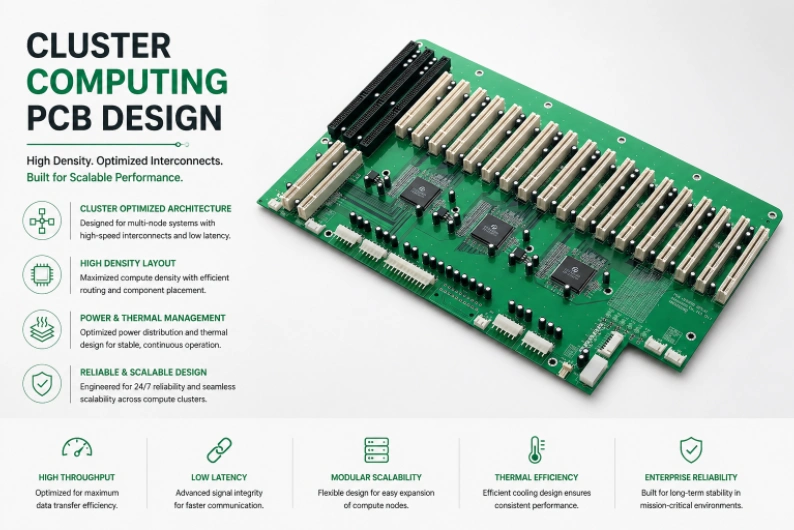
Глобальный рынок кластеров HPC (высокопроизводительных вычислений) в 2024 году превысил 49 миллиардов долларов, при этом обучение корпоративного ИИ и научное моделирование стимулируют спрос на более тесную интеграцию узлов, более широкую полосу пропускания межсоединений и конфигурации с высокой плотностью графических процессоров (GPU), что подталкивает проектирование печатных плат для блейд-серверов к пределам возможного. Кластерные вычисления объединяют совместно размещенные узлы через межсоединения с высокой пропускной способностью и низкой задержкой, обеспечивая возможность параллельных рабочих нагрузок с тесной связью (tightly-coupled), при которых узлы обмениваются данными каждую миллисекунду во время барьерных синхронизаций MPI, операций all-reduce и обмена с соседями в шаблонных вычислениях (stencil computations).
Критическим различием между кластерными вычислениями и слабосвязанными распределенными системами является интенсивность коммуникации. CFD-моделирование (вычислительная гидродинамика), выполняемое на 512 узлах кластера, производит операции MPI_Allreduce, в которых каждый узел участвует тысячи раз в секунду, и при каждой синхронизации ожидается завершение работы самого медленного узла. Задача по обучению ИИ, выполняющая параллельное по данным усреднение градиентов на 256 узлах GPU, выполняет операции all-reduce после каждого мини-батча, при этом задержка сети напрямую добавляется к времени итерации обучения. Такая интенсивность коммуникации означает, что путь межсоединения — и несущая его печатная плата — определяет, улучшает ли добавление узлов производительность или создает накладные расходы (overhead).
HILPCB производит печатные платы для кластерных вычислений, включая платы формата «блейд» длиной 500 мм с допуском плоскостности 0,2%, платы-адаптеры InfiniBand HDR/NDR и узлы объединительных панелей (midplane/backplane), для системных интеграторов, создающих кластеры HPC и кластеры для обучения ИИ в Северной Америке, Европе и Азиатско-Тихоокеанском регионе.
Навигация по меню
- Архитектура узла «Межсоединение прежде всего» (Interconnect-First)
- Трассировка InfiniBand HDR/NDR и высокоскоростного Ethernet
- Форм-фактор Blade: трассировка в коридоре 30×500 мм
- Многокиловаттное распределение питания для блейд-серверов с высокой плотностью GPU
- Надежность для безостановочной работы кластера
- Интегрированное производство блейд-плат и объединительных панелей
Архитектура узла «Межсоединение прежде всего» (Interconnect-First)
Современные узлы кластера строятся на базе процессоров серверного класса или ускорителей GPU, поддерживаются 8-12 каналами DDR5, расширением PCIe Gen 5 и межсоединением InfiniBand или Ethernet 200G/400G. Критическая философия проектирования, отличающая кластерные платы от обычных серверных плат, заключается в приоритете межсоединений: сетевой интерфейс получает самый короткий путь PCIe, слои трассировки с наилучшей целостностью сигнала и наиболее выгодное температурное положение по сравнению с любой другой подсистемой.В стандартном сервере сетевой интерфейс — это одно из множества периферийных устройств, конкурирующих за линии PCIe и ресурсы трассировки платы. В узле кластера, предназначенном для коммуникации MPI, сетевой интерфейс работает на линейной скорости постоянно — InfiniBand NDR 400G поддерживает двунаправленную полосу пропускания 50 ГБ/с без периодов простоя, которые облачные серверы испытывают между независимыми запросами. Этот устойчивый профиль загрузки означает, что любой недостаток целостности сигнала на сетевом пути напрямую ограничивает совокупную вычислительную пропускную способность кластера.
Специфические приоритеты проектирования для кластеров
- Распределение PCIe по принципу Interconnect-First: Сетевой HCA (Host Channel Adapter) или SmartNIC размещается на линиях PCIe Gen 5 x16, идущих напрямую от корневого комплекса (root complex) процессора, обеспечивая самый короткий путь PCIe на плате с наименьшими потерями и наименьшей задержкой. Устройства хранения и периферия получают оставшиеся линии PCIe через коммутатор или порты downstream.
- Многоканальная память DDR5 для работы с MPI с интенсивным использованием данных: 8-12 каналов DDR5, трассированных с согласованием длины байтовых групп (byte-lane) в пределах ±1 мил на слоях высокоскоростной печатной платы (High-Speed PCB). Это поддерживает максимальную пропускную способность памяти для буферных операций MPI, где производительность упаковки/распаковки сообщений ограничена пропускной способностью памяти.
- Интеграция ускорителей GPU: Слоты PCIe Gen 5 x16 для 4-8 ускорителей GPU с системой питания, поддерживающей более 500 Вт на плату за счет распределения питания через слои из толстой меди (Heavy Copper) от 48-вольтовой объединительной панели — узлы кластера, оснащенные GPU, суммарно рассеивают 2000-4000 Вт, что требует инфраструктуры электропитания, превосходящей стандарты обычного серверного дизайна.
- Интерфейс коннектора Midplane: Контактные площадки (footprints) краевого разъема платы, в точности соответствующие спецификациям объединительной панели (midplane) шасси, при этом сохраняется непрерывность импеданса в переходной зоне от платы к разъему — что проверяется с помощью измерения S-параметров интерфейса сопряжения на этапе квалификации первого изделия (first-article).
Трассировка InfiniBand HDR/NDR и высокоскоростного Ethernet
Задержка коммуникации MPI напрямую определяет эффективность масштабирования кластерного приложения. Путь сети на печатной плате — от корневого комплекса PCIe процессора через трассы платы, переходы через переходные отверстия и разъем до SerDes сетевого HCA — вносит прямой вклад в задержку каждой операции MPI и определяет максимальную достижимую пропускную способность фабрики (fabric bandwidth).InfiniBand NDR со скоростью 400G на порт использует 4 линии с сигналом 100G PAM4 — каждая линия работает на той же скорости передачи данных, которая всего 3 года назад требовала материалов со сверхнизкими потерями и прецизионного производства даже для самых требовательных плат коммутаторов. Теперь это требование к целостности сигнала применяется к каждой плате кластерного узла в системе.
Целостность сигнала межсоединения
- Трассировка InfiniBand NDR 400G: 4 линии × 100G PAM4 на порт с вносимыми потерями менее 4,5 дБ на частоте Найквиста 26,5 ГГц — достигается за счет применения ламинатов с низкими потерями (High-Frequency PCB) (Df < 0,003 на 15 ГГц), медной фольги типа HVLP (Rz < 2,0 мкм) и устранения отрезков переходных отверстий (via stubs) посредством технологии обратного сверления (back-drilling) или конструкций со слепыми отверстиями на всех межслойных переходах.
- Оптимизация пути RDMA GPU-Direct: Прямая трассировка PCIe от слота GPU до сетевого адаптера с минимальным количеством переходов (с нулевым пересечением коммутаторов PCIe) и постоянным импедансом через все переходы — обеспечивающая межпроцессорную связь GPU-GPU между узлами на линейной скорости 400G без участия центрального процессора, что критически важно для коллективных операций NCCL/RCCL при распределенном обучении ИИ.
- Детерминированная задержка по аппаратному пути: Неоднородности импеданса и резонансы отрезков (stubs) отверстий создают межсимвольную интерференцию (ISI), которая проявляется как зависимое от данных изменение задержки — увеличивая 99-й перцентиль "хвостовой" задержки (tail latency), что становится узким местом для барьерных синхронизаций MPI, где самая медленная коммуникация определяет время ожидания в масштабах всей системы.
- Производственная проверка глазковой диаграммы: Качество канала проверяется путем измерения глазковой диаграммы на скоростях данных 100G PAM4 на первых образцах плат (first-article) — а не только статическим измерением импеданса методом TDR, при котором не учитываются частотно-зависимые механизмы потерь, доминирующие на скоростях PAM4.
Форм-фактор Blade: трассировка в коридоре 30×500 мм
Блейд-серверы максимизируют плотность вычислений — шасси 10U вмещает 16-20 лезвий (блейдов), каждое из которых содержит полноценный вычислительный узел на печатной плате, ограниченной по ширине примерно 30 мм, а по длине — до 500 мм. Такое экстремальное соотношение сторон (16:1 или выше) создает проблемы с трассировкой и тепловыделением, в корне отличающиеся от проектирования стандартной серверной материнской платы.Специфические проблемы проектирования печатных плат для блейд-серверов
- Доминирование длины при трассировке сигналов: Все высокоскоростные сигналы пересекают всю длину платы от 400 до 500 мм — шины команд/адресов DDR5 простираются на 100-150 мм, линии PCIe x16 тянутся более чем на 200 мм до разъема объединительной панели, а трассировка шин питания охватывает всю плату. Такие длины агрессивно поглощают бюджет вносимых потерь — стандартный материал FR-4 с Df 0,020 на частоте 10 ГГц создает на трассах DDR5 потери свыше 6 дБ, что превышает допуски по времени, принуждая выбирать материалы с низкими потерями даже для интерфейсов, которые нормально работают на стандартном FR-4 в более широких форматах плат.
- Механическая интеграция разъема объединительной панели (Backplane Connector): Контактные площадки разъема со стороны блейд-сервера жестко фиксируются спецификацией шасси (как правило, PICMG 3.0 или проприетарной спецификацией) — компоновка печатной платы должна точно попадать в позиции выводов в пределах ±2 мил (тысячных долей дюйма) при одновременном сохранении импеданса дифференциальной пары в зоне перехода плата-разъем на базе многослойных конструкций (Multilayer PCB) толщиной в 16-24 слоя.
- Ограниченный теплоотвод: Интервал 30 мм между блейд-серверами ограничивает высоту радиатора до 15-20 мм при минимальном поперечном потоке воздуха. Отвод тепла зависит от тепловых интерфейсов на краю платы (медные тепловые мосты, отводящие тепло к холодным направляющим шасси) и контактных площадок на нижней стороне — внутренние слои из толстой меди (Heavy Copper) (2-3 унции) обеспечивают существенное боковое распределение тепла от сконцентрированных пятен нагрева кристаллов к тепловым мостам на краях платы.
- Контроль коробления при экстремальном соотношении сторон: Длинные и тонкие блейд-платы по своей природе подвержены короблению (деформации изгиба/кручения) — соотношение длины и ширины многократно усиливает любую асимметрию распределения меди. Симметричное распределение меди по всем слоям и сбалансированная последовательность прессования (lamination sequence) сохраняют плоскостность в пределах ±0,2% по диагонали — что критически важно для надежного соединения разъема объединительной панели и стабильного контакта теплового интерфейса.
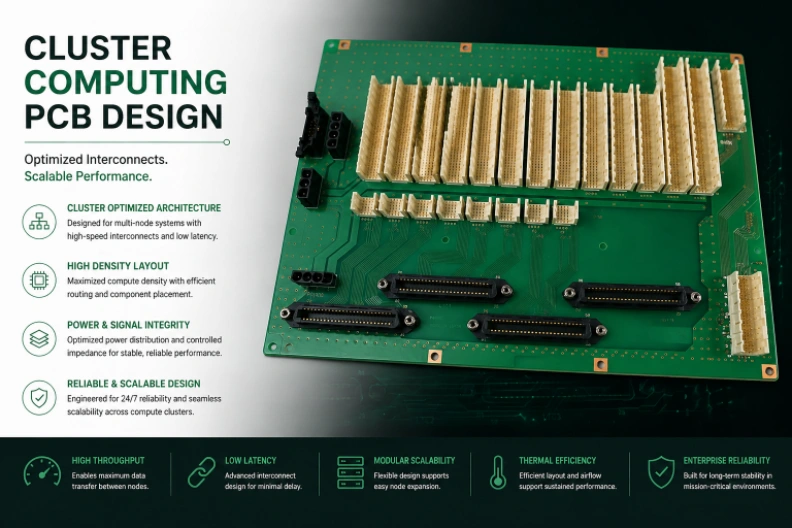
Многокиловаттное распределение питания для блейд-серверов с высокой плотностью GPU
Блейд-серверы кластера, оснащенные GPU, представляют собой устройства с самой высокой плотностью энергопотребления в любом вычислительном форм-факторе — лезвие с 2 центральными процессорами и 4 графическими ускорителями потребляет 2500-4000 Вт от 48-вольтовой шины объединительной панели, и вся эта мощность преобразуется в несколько шин с напряжением менее 1 В в пределах контактной площадки печатной платы. Шасси 10U с 16 такими лезвиями концентрирует от 40 до 64 кВт на площади, занимающей менее половины стойки — это плотность энергии, превышающая показатели большинства коммерческих электронных устройств на порядок.Архитектура электропитания блейд-сервера
- Преобразование 48 В «Direct-to-Load» (напрямую к нагрузке): Двухступенчатая архитектура (промежуточная шина 48В→6В + многофазный понижающий преобразователь 6В→Vcore), которая снижает распределительные потери в 4-6 раз по сравнению с 12-вольтовой шиной. Трассировка 48 В выполняется на выделенных слоях питания с соблюдением соответствующих путей утечки по поверхности (creepage distance) (>0,5 мм для функциональной изоляции согласно стандарту IEC 62368-1) и управлением переходными процессами при коммутации полумостовых преобразователей 48 В, работающих на частоте 300-500 кГц.
- Активное разделение тока между резервными входами (Active Current Sharing): Резервные вводы 48 В от объединительной панели (midplane) с активным выравниванием токов — для поддержания бесперебойного электропитания при отказах модулей питания по схеме N+1 без скачков напряжения, которые могли бы вызвать перезагрузку процессоров или повреждение данных вычислений, находящихся в обработке (in-flight computation).
- Компенсация падения напряжения (Voltage Droop) при переходных процессах GPU: Запуск ядра графического процессора создает скачки тока со скоростью 200-300 А/мкс при переходе от простоя к полной нагрузке. Импеданс линии нагрузки (load-line impedance) калибруется для компенсации падения напряжения (IR drop) на печатной плате, обеспечивая поддержание регулировки напряжения на контактных площадках кристалла процессора в диапазоне ±5 мВ на протяжении всего переходного события.
- Телеметрия питания на каждой шине: Измерение тока на основе шунта (точность ±1%) и мониторинг напряжения на каждой крупной шине — данные передаются в контроллер управления платой (BMC) для управления питанием на уровне стойки, контроля теплового режима и предиктивного обслуживания посредством выявления аномалий в шаблонах энергопотребления.
Надежность для безостановочной работы кластера
Узлы кластера работают непрерывно годами. Внеплановое обслуживание одного-единственного узла заставляет останавливать текущие задачи MPI, создавать контрольные точки (checkpoint), эвакуировать вышедший из строя узел и выполнять перезапуск — процесс, который может стоить часов вычислительного времени на сотнях узлов в случае крупномасштабного моделирования. Это делает полевую надежность (field reliability) доминирующим фактором совокупной стоимости владения для кластерных вычислительных систем.Структура обеспечения надежности кластера
- Расширенная квалификация компонентов: Для электролитических конденсаторов применяются понижающие коэффициенты (derating) — их номинальное напряжение снижено на 30%, а температура — на 20% сверх предельных значений. Для многослойных керамических конденсаторов (MLCC) в качестве минимума указан диэлектрик X7R (а для цепей с критичными требованиями к синхронизации — C0G). МОП-транзисторы (MOSFET) имеют значение термосопротивления Rdson, обеспечивающее поддержание 25% запаса сверх максимального постоянного тока при наихудшей температуре перехода (junction temperature).
- Поверхностный монтаж (SMT-сборка) для увеличения срока службы: Паяные соединения из сплава SAC305 проходят квалификацию на выносливость к термоциклированию: более 3000 циклов согласно IPC-9701 в реальном диапазоне рабочих температур блейд-сервера. Это в 3 раза превышает стандартную квалификацию в 1000 циклов и подтверждается анализом поперечных шлифов (cross-section analysis) и испытаниями на растяжение/сдвиг (pull/shear) по окончании циклов.
- Предиктивное обнаружение сбоев: Интерфейсы датчиков контроллера BMC осуществляют мониторинг фазных токов модуля VRM, эквивалентного последовательного сопротивления (ESR) конденсаторов (посредством измерения импеданса), частоты ошибок модулей DIMM (посредством счетчиков ECC) и тепловых тенденций (thermal trending) — что позволяет выполнять плановую замену деградирующих компонентов до их полного отказа в пределах окон планового обслуживания.
- Архитектура, пригодная для обслуживания на объекте (Field-Serviceable): Модульная конструкция платы с доступными контрольными точками для диагностики на месте с использованием стандартного мультиметра и осциллографа — это дает возможность техническим специалистам 2-й линии поддержки выявлять вышедшие из строя подсистемы без отправки плат обратно производителю.
Интегрированное производство блейд-плат и объединительных панелей
Программы по созданию кластеров следуют структурированным этапам сборки: 5-10 тестовых плат для разработки прошивки (bring-up), 50-200 пилотных плат для системной интеграции и 500-10 000+ серийных изделий для внедрения у заказчика. Уникальная технологическая проблема кластерных вычислений заключается в том, что печатные платы для блейд-серверов и объединительных панелей (midplane/backplane) должны производиться вместе с координированным контролем размеров, поскольку сопряжение разъемов между лезвием и объединительной панелью зависит от того, будут ли обе платы одновременно соответствовать их индивидуальным спецификациям допусков.Координированное производство
- Сборка прототипов (Prototype Bring-Up): Производство от 5 до 10 плат для блейд-серверов вместе с соответствующими секциями объединительной панели (midplane) поставляются за 5-7 рабочих дней при условии полного обеспечения комплектующими. Это дает возможность одновременно заниматься разработкой микропрограммного обеспечения лезвий и тестированием интеграции объединительной панели.
- Совместное производство объединительных панелей (Midplane Co-Fabrication): Платы для лезвий (блейдов) и платы объединительных панелей (midplane/backplane) изготавливаются с проведением скоординированной проверки соосности коннекторов. В частности, речь идет о многослойных объединительных платах (Multilayer Backplane) (включающих до 40 и более слоев) с отверстиями под запрессовку разъемов (press-fit), имеющими допуск расположения ±1,5 мил, которые сверяются с ответными контактными площадками разъемов плат блейд-серверов.
- Масштабирование «под ключ» (Turnkey Scaling): Автоматизированная сборка со внутрисхемным тестированием (ICT), периферийным сканированием (boundary scan), функциональными тестами и испытаниями на приработку (burn-in). Гарантирует идентичность плат для блейд-серверов на протяжении всех производственных партий, охватывающих многомесячный период внедрения у клиента.
- Системная проверка разъемов: Измерение усилия сочленения и проверка контактного сопротивления в парах разъемов блейд-мидплейн — для обеспечения надежного электрического соединения на протяжении более чем 50 000 циклов сочленения, ожидаемых в течение всего срока службы системы.
FAQ по печатным платам для кластерных вычислений
С какими экстремальными проблемами в плане трассировки сталкиваются печатные платы блейд-серверов?
Печатные платы блейд-серверов отличаются сверхвытянутыми пропорциями (например, 30x500 мм), а это значит, что высокочастотным сигналам, таким как PCIe x16 или DDR5, приходится преодолевать огромные расстояния. Такая длина интенсивно истощает допустимый уровень вносимых потерь, что принуждает к использованию материалов со сверхнизкими потерями и высокоточному управлению импедансом с целью сбережения целостности сигнала от процессора вплоть до коннектора объединительной панели.
Каким образом организовано распределение питания на кластерных блейд-серверах с высокой концентрацией графических процессоров (GPU)?
Энергопотребление кластерного блейд-сервера с несколькими графическими процессорами может достигать 2500–4000 Вт. Чтобы продуктивно управлять такими показателями, на платах внедряется архитектура трансформации напряжений 48 В «direct-to-load» (напрямую к нагрузке), оснащенная конвертерами промежуточной шины. Трассы пролегают по выделенным энергетическим слоям, выполненным из толстой меди, что минимизирует падение напряжения (IR Drop) и помогает справляться со значительными переходными токами (high current transients) во время скачкообразных перегрузок GPU.
По какой причине печатные платы блейд-серверов и объединительных панелей (midplane) в обязательном порядке производятся совместно?
Безотказность контакта между блейд-сервером и объединительной панелью опирается на выверенное позиционирование коннекторов. Параллельное создание обеих плат поручается тому, что посадочные места (footprints) под разъемы на блейд-сервере и отверстия под запрессовку (press-fit) на объединительной панели подчиняются унифицированным габаритным допускам, ручаясь за плотную стыковку и электрическую монолитность.