
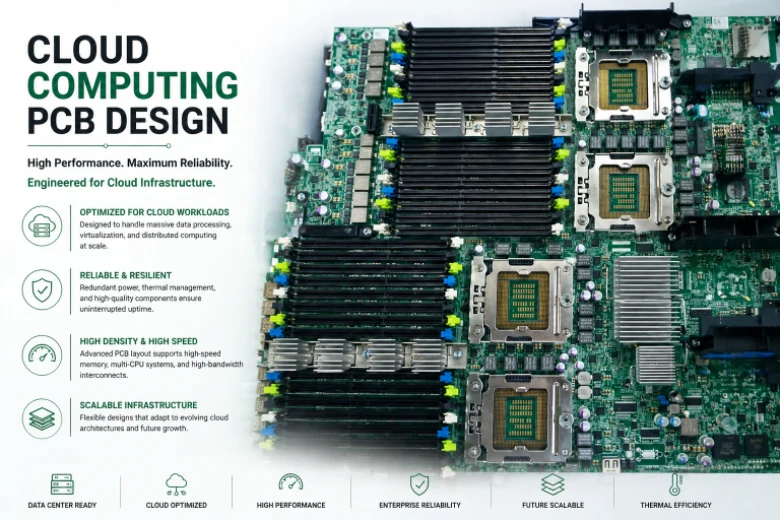
Il mercato globale dei servizi di infrastruttura cloud ha raggiunto i 330 miliardi di dollari nel 2024 (Synergy Research), con AWS, Azure, Google Cloud e fornitori regionali che distribuiscono circa 3 milioni di nuovi server ogni anno — ognuno dei quali contiene PCB realizzati secondo standard di qualità hyperscale, dove un tasso di guasto delle schede dello 0,1% si traduce in 3.000 guasti simultanei che generano ticket di assistenza, sanzioni sui contratti SLA (Service Level Agreement) e logistica di sostituzione su scala globale. Il cloud computing concentra massicce capacità di elaborazione, archiviazione e rete nei data center hyperscale, fornendo il "compute-as-a-service" attraverso un hardware le cui prestazioni, efficienza energetica e affidabilità sono determinate a livello di PCB.
L'economia dell'hardware per il cloud è fondamentalmente diversa da quella del computing aziendale tradizionale. Un provider hyperscale che valuta le schede madri dei server non si chiede "questa scheda funziona?" — piuttosto, calcola il costo totale di proprietà (TCO) su distribuzioni da 100.000 unità in cui un risparmio energetico di 2W per server elimina 200 kW di carico ($175.000/anno in elettricità), un miglioramento dell'affidabilità dello 0,05% evita 50 sostituzioni sul campo all'anno ($25.000 in interventi tecnici) e una riduzione della distinta base (BOM) di $3 per scheda consente di risparmiare $300.000 per generazione. Ogni decisione progettuale sul PCB comporta conseguenze finanziarie su scala dell'intero parco macchine.
HILPCB produce PCB per cloud computing — fornendo schede server da 16 a 28 strati con volumi superiori alle 5.000 unità al mese e con una coerenza di impedenza Cpk >1,33 — per OEM di server, fornitori di storage e aziende di networking che costruiscono l'infrastruttura fisica del cloud computing in tutto il mondo.
Menu di navigazione
- L'economia su scala cloud a livello di scheda
- Integrità del segnale della scheda madre del server: DDR5, PCIe Gen 5 e CXL
- Progettazione della piattaforma e del controller di storage NVMe
- Produzione di switch di rete e schede di rete 400G/800G
- Efficienza energetica e progettazione termica per la massima densità del rack
- Produzione in volumi e continuità di fornitura
L'economia su scala cloud a livello di scheda
Le decisioni di acquisto di hardware per il cloud vengono prese attraverso una rigorosa modellazione del TCO (Total Cost of Ownership) su cicli di implementazione di 3-5 anni. Il PCB non viene valutato come un componente isolato, ma come un fattore che contribuisce alle prestazioni per watt, all'affidabilità per dollaro e al costo di produzione su vasta scala. La nostra collaborazione di co-design con gli OEM di hardware cloud ottimizza queste dimensioni del TCO, dalla definizione iniziale dello stack-up (sovrapposizione degli strati) fino all'aumento dei volumi di produzione.Dimensioni dell'ottimizzazione dei PCB per il Cloud
- Prestazioni per Watt: Massimo throughput di calcolo per watt di potenza totale del sistema — portando avanti l'ottimizzazione dell'integrità del segnale (raggiungendo l'intera larghezza di banda dell'interfaccia senza il sovraccarico delle ritrasmissioni), l'ingegneria dell'efficienza del VRM (>93% a carico tipico) e la selezione di materiali a bassa perdita che riducono il riscaldamento dielettrico del PCB.
- Affidabilità su scala del parco macchine: MTBF continuo di 5 anni con l'obiettivo di un tasso di guasto annuale delle schede <0,1% su flotte da 100.000 unità — ottenuto attraverso il derating dei componenti (30% di tensione, 20% di temperatura sui condensatori elettrolitici), la qualificazione dei giunti di saldatura (oltre 2.500 cicli termici in conformità alla norma IPC-9701) e la verifica del materiale in ingresso per prevenire difetti latenti.
- Costo di produzione in volume: Ottimizzazione del costo della distinta base (BOM) attraverso valori standardizzati dei componenti passivi (riducendo i codici prodotto univoci del 30-40%), massimizzazione dell'utilizzo del pannello (risparmio di materiale del 15-20% tramite un layout ottimizzato del raggruppamento) e progettazione orientata al DFM che consente di raggiungere un rendimento SMT al primo passaggio >95%.
- Manutenibilità e gestione remota: Capacità di hot-swap per le unità sostituibili sul campo, array di sensori BMC completi con API Redfish e indicatori LED diagnostici — che riducono il tempo medio di riparazione da ore a minuti e consentono il funzionamento headless del data center.
Integrità del segnale della scheda madre del server: DDR5, PCIe Gen 5 e CXL
Le schede madri dei server cloud supportano simultaneamente le interfacce commerciali più veloci: DDR5 a 4800–6400 MT/s su 8-12 canali, PCIe Gen 5 a 32 GT/s su più di 128 linee, CXL 2.0 per l'espansione e il pooling della memoria, e UPI/GMI per l'interconnessione multi-socket a 16-24 GT/s. Ciascuna interfaccia ha budget di perdita che lasciano un margine minimo al contributo del PCB, e tutte condividono la stessa costruzione della scheda a 16-28 strati, competendo per gli strati di instradamento ottimali e le risorse del piano di riferimento.Ingegneria dell'integrità del segnale dei server
- Routing DDR5 a 5600+ MT/s: Impedenza single-ended di 40Ω con adattamento della linea di byte a ±1 mil e topologia fly-by simulata per il margine di tempistica del write-leveling (livellamento in scrittura) in ogni popolazione DIMM supportata (1DPC e 2DPC). Il regolatore di tensione on-DIMM delle DDR5 richiede un routing aggiuntivo per l'erogazione di potenza che è assente nei progetti DDR4 — binari di alimentazione VR12.5 instradati a fianco dei bus dati della memoria con un adeguato isolamento.
- Interconnessione Multi-Socket a 24 GT/s: Collegamenti UPI 2.0 (Intel) e GMI3/Infinity Fabric (AMD) che attraversano da 6 a 12 pollici tra i socket del processore con una perdita di inserzione inferiore a 8 dB a 12 GHz — il che richiede laminati a bassa perdita (Df < 0,004 a 10 GHz) e vie con perforazione posteriore (back-drilled) con stub <8 mil su costruzioni da 16 a 28 strati.
- Espansione di memoria CXL 2.0: Interfacce di espansione della memoria CXL Tipo 3 che condividono il livello fisico PCIe Gen 5 — instradate a fianco degli slot PCIe standard ma che richiedono un'allocazione più rigorosa del budget del jitter perché il protocollo di coerenza della cache di CXL è meno tollerante alla latenza della ritrasmissione a livello di collegamento rispetto alle scritture "posted" di PCIe.
- Verifica dell'impedenza in produzione: Misurazione dell'impedenza TDR sui coupon di test di ogni pannello di produzione, con la conformità del diagramma a occhio (eye diagram) verificata sui primi articoli (First Article Inspection) alle velocità di trasmissione dati delle DDR5 (5600 MT/s) e PCIe Gen 5 (32 GT/s) utilizzando una strumentazione BERT calibrata.
Progettazione della piattaforma e del controller di storage NVMe
L'infrastruttura di archiviazione cloud si basa su SSD NVMe aggregati dietro circuiti integrati (IC) switch PCIe — il PCB del controller di archiviazione instrada da 16 a 96 corsie di PCIe Gen 4/5 dall'ASIC dello switch ai connettori delle unità SFF-8639, E1.S o E3.S, e ogni corsia richiede un controllo dell'impedenza e una verifica delle perdite individuali. Queste schede rappresentano contemporaneamente complesse progettazioni digitali ad alta velocità (PCIe a 32 GT/s) e sfide per la gestione della potenza (IC switch che dissipano da 30 a 100 W in fattori di forma ristretti).Progettazione della scheda del controller di archiviazione
- Routing Fan-Out PCIe: Distribuzione del segnale (fan-out) dallo switch PCIe Gen 5 su distanze da 100 a 300 mm su costruzioni multistrato (da 14 a 20 strati) con strati di segnale in laminato a bassa perdita, transizioni via retroforate e geometria ottimizzata del lancio dei connettori — per mantenere la perdita di canale all'interno delle specifiche su tutte le 16-96 corsie simultaneamente.
- Coesistenza di protocolli misti: Strati di instradamento dedicati per PCIe (85Ω differenziale) e SAS tradizionale (100Ω differenziale) con schermatura del piano di massa continua tra i protocolli, evitando la diafonia tra i segnali PCIe a 32 GT/s e i segnali SAS a 22,5 Gbps, che causerebbe errori di bit nel percorso dei dati di archiviazione.
- Gestione termica del controller: I circuiti integrati (IC) degli switch di archiviazione dissipano 50-100W nei formati scheda HHHL o FHFL con array di vie termiche, piani di alimentazione in rame spesso (2-3 oz) e una disposizione dei componenti ottimizzata per i flussi d'aria vincolati — mantenendo la temperatura di giunzione al di sotto della soglia di limitazione (throttling) con un margine di 10°C sotto carichi di lavoro in scrittura casuale prolungati.
- Verifica del diagramma a occhio per corsia (Per-Lane): La conformità del diagramma a occhio viene misurata su ogni linea PCIe durante l'ispezione del primo articolo — in quanto una singola corsia con un margine visivo limite (marginal eye) crea un addestramento intermittente del collegamento (link retraining) che peggiora le IOPS (operazioni di input/output al secondo) dello storage e la tail latency (latenza di coda), manifestandosi come un problema di prestazioni dello storage anziché come un difetto del PCB.
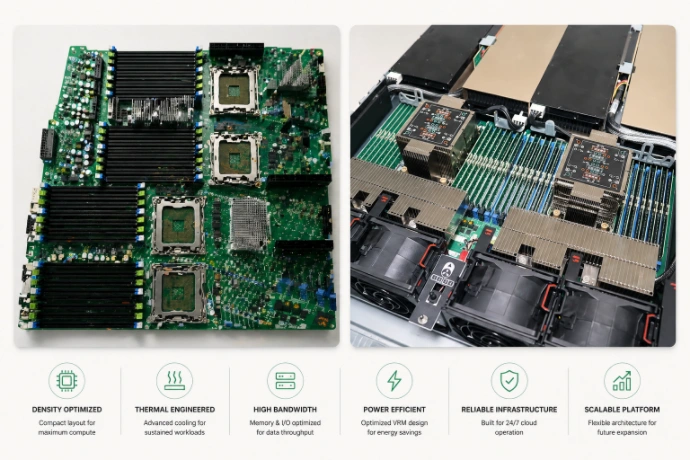
Produzione di switch di rete e schede di rete 400G/800G
I data center cloud collegano i server tramite NIC da 25G/100G/400G e switch Top-of-Rack (ToR) in grado di gestire milioni di pacchetti al secondo. Gli switch 800G di nuova generazione utilizzano SerDes PAM4 112G (8×112G per porta) ed è in fase emergente il PAM4 da 224G — creando schede che sono contemporaneamente sfide di progettazione digitale ad altissima velocità e analogica di grado RF. I PCB delle NIC (Network Interface Card) supportano IC PHY di rete con 32–64 linee SerDes, interfacce host PCIe Gen 5, array di connettori QSFP-DD/OSFP e sofisticati sistemi di erogazione della potenza, tutto su schede che misurano 150×200 mm.Capacità di produzione delle schede di rete
- Progettazione del canale 400G/800G: 8×50G PAM4 (400G) o 8×112G PAM4 (800G) per porta con perdita di inserzione inferiore a 5 dB a 26,5 GHz (400G) o inferiore a 4 dB a 56 GHz (800G) — impiego di laminati ad alta frequenza (Dk 3.0, Df < 0,002 a 28 GHz) sui layer del segnale, combinati con FR-4 standard sui layer di alimentazione/terra per la gestione dei costi nella produzione di massa.
- Switch ASIC BGA Escape: Dai 5.000 ai 7.000+ pad BGA con centinaia di corsie SerDes 112G che richiedono un PCB HDI a laminazione sequenziale su costruzioni a 24–36 strati (capacità fino a 64 strati). Microvie perforate a laser (0,075 mm) con strutture a via sovrapposte (stacked vias) per completare l'instradamento di "fuga" (escape) degli ASIC all'interno dell'ombra del package — ogni corsia SerDes è sintonizzata singolarmente per quanto riguarda l'impedenza tramite l'ottimizzazione delle pad "anti-via" (anti-pad).
- Distribuzione di potenza delle NIC per elaborazioni a Line-Rate: I circuiti integrati (IC) PHY di rete assorbono dai 25 ai 50W di potenza da alimentazioni core di 0,75–1,0V, con regolazione multifase in grado di mantenere la tensione con una tolleranza del ±2% anche nel peggiore dei casi di elaborazione di pacchetti a "line-rate" e con crittografia completa. La risposta transitoria dei moduli VRM è appositamente progettata per gestire i pattern di traffico intermittenti (a raffica) che caratterizzano le comunicazioni est-ovest all'interno dei data center.
- Pre-conformità EMI: Valutazione EMI integrata nel layout tramite la scansione in campo vicino (near-field) — che ottimizza le emissioni irradiate dovute a discontinuità nei piani (slot antenna radiation), messa a terra dello schermo dei connettori, nonché il contenimento delle armoniche di clock, agendo in fase di progettazione della scheda per prevenire problemi che si scoprirebbero solo durante i test di certificazione FCC/CE/VCCI.
Efficienza energetica e progettazione termica per la massima densità del rack
I data center cloud sono fondamentalmente soggetti a vincoli energetici: ogni watt consumato dalle perdite del PCB (inefficienza del modulo VRM, perdita resistiva del rame, surriscaldamento del dielettrico) diminuisce la capacità di calcolo disponibile. Su scala di intere flotte, i miglioramenti nell'efficienza energetica del PCB si sommano: un miglioramento di soli 2W per server su una base di 100.000 server riduce 200 kW di carico IT e proporzionalmente dai 60 ai 100 kW di carico di raffreddamento, determinando risparmi superiori ai $225.000 all'anno.Efficienza e ottimizzazione termica
- Profilazione dell'efficienza VRM: IC del convertitore scelti e valutati in funzione del profilo di carico specifico (e non limitatamente al picco di efficienza) — l'obiettivo è superare il 93% con carico tipico del 50-70%, >88% a carico passivo del 10% e >90% al 100% di carico continuo. La frequenza di commutazione, la selezione dell'induttore e l'intensità di attivazione del gate sono calibrati per ottimizzare l'efficienza ponderata sul carico in base all'effettivo profilo operativo del server.
- Ingegneria dell'IR Drop (caduta di tensione): I bus di alimentazione a 3,3V e 5V, che convogliano dai 10 ai 30A per tratti che vanno dai 6 ai 10 pollici, esigono uno spessore del rame calcolato individualmente e verificato per mezzo di simulazioni della caduta di tensione in corrente continua (DC IR drop). Spesso viene prescritto l'utilizzo selettivo di rame spesso da 2-3 oz per gli strati ad elevata corrente all'interno di una configurazione standard da 1 oz, così da ridurre la perdita resistiva pur contenendo i costi di produzione negli strati restanti.
- Layout 1U ottimizzato per i flussi d'aria: La disposizione dei componenti crea canalizzazioni fluide e libere da ostruzioni che guidano l'aria dall'ingresso frontale fino allo scarico posteriore in rack di tipo 1U, che dispongono di un'altezza massima netta variabile dai 40 ai 44 mm. Gli elementi di maggiori dimensioni, come le induttanze per moduli VRM o i condensatori elettrolitici, vengono sistemati a "valle", sfruttando in tal modo il beneficio del flusso d'aria "a monte" e prevengono il rischio di formare barriere per le parti successive.
- Derating termico per le condizioni dei data center: La scelta della componentistica assicura le idonee curve di "derating" termico, garantendo la piena operatività sia a fronte di un'alimentazione d'aria di 35°C (che corrisponde alla classe A1 del protocollo ASHRAE) sia di 45°C (che corrisponde alla classe A3/A4 per le infrastrutture munite di "free cooling") — la rapida e diffusa adozione dei metodi a ciclo continuo privo di refrigerazione forzata eleva le normali quote di riscaldamento ambientali ad un limite estraneo ai criteri architetturali pre-esistenti in ambito data center.
Produzione in volumi e continuità di fornitura
La fabbricazione dell'hardware riservato agli ambienti cloud è regolamentata da precisi paradigmi: lo scadenziario prevede fasi progettuali comprese tra i 6 e i 12 mesi, governate dall'evoluzione dei nuovi gruppi di microprocessori; si avviano repentini sviluppi capaci di proiettare in un intervallo di 8 o 12 settimane l'esecuzione da semplici lotti di campionatura a svariate centinaia di referenze su base mensile; si prosegue per 18 o 24 mesi consecutivi al pieno regime di volumi, concludendo l'esercizio mediante un fine vita coordinato (EOL - End of life) e garantendo una successiva finestra per il "Last Time Buy" (ultimo approvvigionamento utile) di circa 12 mesi. Le doti di adattabilità e continuità nella consegna sanciscono il rispetto (o meno) delle tabelle di marcia che i committenti si propongono, e il ritardo di appena 4 settimane per un lotto di server può sospendere per tre mensilità integrali l'attivazione di infrastrutture del valore di 50 milioni di dollari.Framework della catena di fornitura e della produzione
- Prototipazione rapida: Schede iniziali destinate all'ambiente di sviluppo recapitate tra 5 e 7 giorni operativi al fine di assecondare l'avvio della piattaforma, la programmazione in ambito BIOS e le conferme attinenti la componente firmware, favorendo così i gruppi al lavoro nella integrazione tecnologica durante i medesimi stadi decisionali delle dotazioni di allestimento finale.
- Qualificazione per le produzioni a titolo di campionamento (Pilot): Elaborazione compresa tra i 100 e i 500 esemplari mirata a confermare i requisiti sui perimetri procedurali, le norme basilari circa l'incidenza degli scarti e i parametri d'idoneità ai collaudi strumentali, fornendo il primo campionario agli esami normativi o alle dimostrazioni commerciali presso l'utente finale.
- Incremento volumi per superare quota 5.000 unità mensili: Struttura interamente votata per l'assemblaggio di natura SMT asservita da moduli "in-circuit test" (ICT), monitoraggio di confine (JTAG / boundary scan) e verifiche circa l'esecutività operativa — un assetto valutato al fine d'offrire livelli conformi sui più alti impegni di distribuzione garantendo l'attività statistica continua a titolo di prevenzione (SPC) rispetto ad ogni comparto maggiormente a rischio.
- Programmazione circa l'assiduità degli approvvigionamenti: Depositi riservati per la componentistica vincolata da termini di rifornimento pari o eccedenti alle 6 settimane, fornitore alternativo pre-validato circa ogni dotazione esclusiva (single-source IC), nonché un regime d'avviso preventivo d'almeno 18 mensilità in merito all'imminente fase conclusiva e cessata della manifattura, assicurando in via definitiva l'immunità dai contraccolpi in fatto di forniture che i programmi articolati sui molteplici cicli annui potrebbero subire.
FAQ sui PCB per Cloud Computing
Quali sono le sfide chiave legate all'integrità del segnale per le schede madri dei server in ambito cloud?
In ambiente cloud, l'architettura su scheda madre esige la contemporanea integrazione di collegamenti ultra veloci, annoverando i più recenti standard quali DDR5 (da oltre 5600 MT/s in avanti), PCIe generazione 5 (capaci di sfiorare i 32 GT/s) e protocolli CXL versione 2.0. A fronte di tali imposizioni si esigono restrizioni ferree d'impedenza, mescole laminari votate ad un'assenza tendenziale d'ogni perdita ed elaborate sagomature circa gli elementi a foro passante (es.: asportazioni meccaniche a tracciatura eseguita - back-drilling), finalizzate al controllo sulla frammentazione delle trasmissioni, il tutto conservando un grado di qualità ed appropriatezza impeccabile, avviluppandosi tra configurazioni complesse fornite da un numero variabile (da 16 a 28) d'elementi stratificati.
Come influisce la progettazione dei PCB sull'efficienza energetica dei data center?
L'efficacia e il grado di assorbimento del PCB sono caratteristiche la cui ripercussione diviene esponenziale sulle ampie concentrazioni dei mainframe operanti a ciclo continuo. Formulare impianti di ridotta dispersione a mezzo potenziale limitando fenomeni legati alla "IR drop" applicando masse in lega rameosa robusta (heavy copper), e calibrare appropriatamente l'efficacia derivante dai moduli delegati all'apporto energetico VRM (Voltage Regulator Module), consente defalcare unità della grandezza dei Watt dalla quota ascrivibile alla singola referenza; tradotto sulla somma di distribuzioni massicce proprie del settore cloud (hyperscale), un simile contributo corrisponde alla capacità di recuperare decine, o talvolta centinaia di chilowatt sull'intero spettro energetico di sistema.
Per quale ragione la componente della corretta gestione termica risulta vitale circa i dispositivi rivolti alla gestione della memorizzazione di tipologia NVMe?
I terminali elaborativi demandati alla conversione PCIe del ramo NVMe raggiungono tassi dissipativi prossimi ai range 50-100W confinati entro quote dimensionali esigue. La gestione e il collocamento ottimizzato degli appositi circuiti ad "array termici", affiancati dall'appropriata espansione di supporti solidi maggiorati capaci d'assolvere al propagarsi delle correnti di calore su superfici diffuse (al fine di contrastare derive verticali), diventano la chiave prioritaria per confinare la temperatura nodale (Junction temperature) su livelli d'immunità verso derive o restrizioni protettive di sorta, preservando prestazioni d'esercizio assidue ed equilibrate (IOPS) riferite ai carichi di memorizzazione.
Programma una revisione in co-design dell'hardware cloud con il nostro team di ingegneria →